Skip to content
Artwork for Seventy3
TechnologyEducationScience

Seventy3

任雨山

73播客,Sheldon最喜欢的数字,内容均为Google NotebookLM原生生成,每天由AI领读最新的前沿论文。欢迎投稿合作。

Play
  • 101 episodes
  • daily
  • Avg 19 min
  • Chinese
Counted on this page — what you have heard stays on this device, so it is not something the list can be paged by.
  • September 22 · 21 min

    【第723期】NOOA:基于面向对象编程的原生Python智能体框架

    今天的这篇的主题是: NVIDIA-labs OO Agents Native Python Object-Oriented Agents Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 传统 Agent 的开发分散于提示词模板(prompt templates)、工具 Schema、回调代码(callback code)以及工作流图(workflow graphs)之中。我们推出了 NVIDIA 面向对象 Agent(NOOA),这是一个用于构建可靠 AI Agent 的通用(model-agnostic)Python 框架。NOOA 采取了一种更为简洁的方法:一个 Agent 就是一个 Python 对象。它的方法即为模型可以采取的动作,属性字段即为其状态,文档字符串(docstrings)即为其提示词,而其类型注解则构成了契约约束。代码体仅由“...”组成的方法会在运行时由 LLM 驱动的 Agent 循环来完成,而包含常规代码体的方法则保持为标准、确定性的 Python 代码。这为开发者和 Agent 提供了相同的接口,使得 Agent 的行为可以像其他软件一样被测试、追踪、重构和改进。 本论文做出了三项主要贡献: (1) 我们提出了“ Agent 即 Python 对象”(agent-as-a-Python-object)的编程模型及其背后的设计原则。在 Python 已有相应抽象的地方,我们直接沿用它们。Agent 的专属能力——如上下文、事件、状态渲染、长期记忆以及经过验证的 LLM 循环——均通过符合 Python 习惯的简洁 API 暴露出来,从而让开发者和 Agent 共享同一种熟悉的编程模型。 (2) 我们总结了六项面向模型的理念,就我们所知,NOOA 是首个在单一统一接口上将它们融为一体的框架:类型化输入/输出、对活对象的引用传递(pass-by-reference over live objects)、代码即动作(code as action)、可编程循环工程(programmable loop engineering)、显式对象状态,以及面向模型可调用的上下文与事件测试框架(harness)API。我们发现社区已经在向其中多项理念收敛(通常作为实验性或部分特性),在此提出这一对比旨在鼓励这些理念被进一步采用。 (3) 我们在定向能力测试以及诸如 SWE-bench Verified、Terminal-Bench 2.0 和 ARC-AGI-3 等 Agent 化与推理基准测试中证明,当前模型能够有效地使用这一接口。 原文链接:https://arxiv.org/abs/2607.20709 前往小宇宙评论区与主播互动
  • September 21 · 16 min

    【第722期】RoboTTT:通过测试时训练扩展机器人策略上下文

    今天的这篇的主题是: RoboTTT: Context Scaling for Robot Policies Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 近期的机器人基础模型通常在单步或短历史的视觉运动(visuomotor)上下文下运行。我们推出了测试时训练机器人策略(RoboTTT),这是一种将视觉运动上下文扩展至 8K 个时间步(比现有最先进策略高出三个数量级)且不会增加推理延迟的机器人模型与训练方案。在这种上下文长度下,我们解锁了全新的机器人能力:从人类视频演示中实现单样本即时上下文模仿(one-shot in-context imitation)、实时策略改进、对扰动的鲁棒性,以及在多阶段、长视角(long-horizon)任务中更强的表现。此外,我们还首次观察到随着预训练上下文长度的扩展,闭环性能获得了稳步提升。 RoboTTT 的核心在于将测试时训练(Test-Time Training)集成到诸如视觉-语言-动作(Vision-Language-Action)策略等机器人基础模型中,构建出一个序列模型,其循环状态(recurrent state)由“快速权重”(fast weights)构成——即在训练和推理过程中均通过梯度下降更新的参数,将历史信息压缩至权重空间,并为长上下文条件化检索上下文信息。为了扩展训练上下文长度,该方案结合了序列动作强制(sequence action forcing)与截断按时间反向传播(truncated backpropagation through time)。 在具挑战性的真实机器人操控任务中,RoboTTT 相比单步上下文基线将整体性能提升了 87%,并完整完成了一项耗时 5 分钟、包含 10 个阶段的装配任务,而无任何基线模型能够做到这一点。使用 8K 时间步上下文训练的 RoboTTT 比使用 1K 时间步预训练的同一模型性能高出 62%,这表明上下文长度可以作为机器人基础模型的一个全新扩展轴(scaling axis)。 原文链接:https://arxiv.org/abs/2607.15275 前往小宇宙评论区与主播互动

  • September 20 · 17 min

    【第721期】结构化输出引发的语言模型答案同质化研究

    今天的这篇的主题是: Structured Output Collapses Answer Diversity Across 44 Language Models Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 当语言模型必须从庞大的等效有效选项空间中选择一个答案时,格式子句(例如“仅以 JSON 格式回复”)会改变其最终选择的答案。我们重新运行了“单词人口普查”(One-Word Census,arXiv:2607.12796):针对 44 个模型提出了 31 个具有宽泛答案空间的类别提示词,而本次则要求以 JSON 格式回复——无模式(schema)强制约束,无约束解码,仅包含这一请求。 收敛程度急剧加深:在无约束的“选择一个词”提示下,众数答案(modal answer)在总体中的占比从 41% 上升至 64%,而独立答案的数量则从 52 个降至 36 个;平均答案选择惊奇度(surprisal)从 1.80 比特降至 1.58 比特。这种“格式税”呈现出渐进性:在 44 个模型中有 6 个模型在个体层面上发生了显著偏移(BH-FDR q=0.10),且全部向众数靠拢,并以最具个性(最独特)的模型为首,而顺从型模型的基线则保持不动。 这是一种“尖锐化”而非“重新索引”——普通对话模式下的众数答案在 31 个类别中的 28 个里得以延续。默认选择呈现出语域索引特征(register-indexed):一次运行内的重采样(n=20)发现,JSON 使得模型 53% 的稳定对话默认选择发生了偏移,且绝大多数退回到了从众选择,并确立了对话模式中不存在的默认选项(例如 Claude Fable 5 在对话模式下回答颜色的选项为“蔚蓝色”的概率为 0%,但在 JSON 模式下为 100%)。 全套对照实验揭示了一种语域梯度(register gradient):压缩效应显著存在,且专门作用于经过训练、专门用于输出的答案交付格式(JSON 减少 0.22 比特,p=0.0002;XML 减少 0.19 比特,p=0.002);该效应在 YAML 和 CSV 中不存在,而在任意括号包裹格式中则发生反转(增加 0.13 比特,p=0.009)——这使得其作用机制更偏向于工具调用的后训练(tool-use post-training)。 在解码器端强制执行模式(response_format)相比单纯的文本请求并不会带来进一步的压缩(仅减少 0.03 比特):这种坍缩存在于模型对语域的反应中,而非来自于解码器本身。结构化输出是软件消费语言模型的主要方式,而这一表面所服务的是一个在测量上比对话表面更加同质化的模型——而后者恰恰是模型被评估、比较和选择时所基于的表面。 原文链接:https://arxiv.org/abs/2607.18476 前往小宇宙评论区与主播互动

  • September 19 · 25 min

    【第720期】智能代理的长文本进阶披露机制评估

    今天的这篇的主题是: Is Progressive Disclosure All You Need for Long-Context Agents? Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 长文档问答通常迫使人们在两种方案之间做出选择:要么将整份文档加载到上下文窗口中,要么外挂一个独立的检索器。Agent 化 AI(Agentic AI)则提供了一个更为宽泛的选项——直接向 Agent 提供文档路径,让其自行决定阅读的方式与内容。Agent Skills 作为一种将专业知识封装到文件夹中供 Agent 按需加载的标准,提供了一种现成的机制:渐进式披露(progressive disclosure),即仅暴露查询所需的信息,从简短的描述一直延伸到特定的段落。从业者们迅速在整本书级别的理解任务中采用了这一模式,但支持此类选择的证据一直停留在轶事层面。 我们针对该模式开展了首次对照研究,在 InfiniteBench 基准上,跨越三种 Agent 框架(harnesses)和三个模型家族,将原始文档导航以及 Agent Skills 包的几种设计方案与传统混合检索器进行了对比。在单本书的场景下,收益取决于所使用的框架:当 Agent 对原始文档的导航能力较差时收益巨大,但当强力 Agent 框架本身就能自行拆分与检索时,收益则接近于零。当扩展到跨多本书的任务时,原始文档导航方式彻底崩溃,而单层渐进式披露的性能衰减则更为缓慢并一举取得领先。第二层更深度的路由层从无助益,有时甚至会直接损害准确率,因此一层就已经足够。渐进式披露换取的是上下文容量,而非智能:当强力 Agent 能够自行定位正确段落时它是冗余的,但一旦语料库增长到无法通过阅读来导航的规模时,它就成为了决定性的关键因素。 原文链接:https://arxiv.org/abs/2607.17598 前往小宇宙评论区与主播互动

  • September 18 · 17 min

    【第719期】GAMUT:大语言模型长文本生成事实完备性评价基准

    今天的这篇的主题是: Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 基于标准(Rubric-based)的开放式生成评估面临着表达力与可靠性之间的根本矛盾。撰写一份忠实准确的评估标准,需要表达出优秀回答空间所具备的结构特征:包含可接受选项的开放式集合、有序的流程以及事实的相对重要性。而使用该标准进行打分,则要求评估器(judge)保持一致性,评估器在处理扁平化的二元检查时,其可靠性远高于处理丰富的结构化内容。 我们通过一个两层元标准(meta-rubric)框架解决了这一矛盾。在撰写阶段,结构化元标准用于捕捉评分标准;随后,固定且机械化的规则会将其编译为由“二元、可由机器打分”的检查项目构成的扁平清单,LLM 评估器即可在评估阶段对其进行可靠的评分。 我们将该框架实例化为 Gamut(长文本事实性接地评估,Grounded Assessment of Multimodal Factuality),这是一个用于评估长文本生成中事实完整性的基准测试。Gamut 包含 1,813 个基于真实穿戴设备图像的问题,涵盖 10 个不同的领域,每个问题均配有由专家人类标注者验证且有证据支持的评估标准。在对 14 个前沿模型及开源模型进行评估后,我们发现 Gamut 极具挑战性(Gemini 3.1 Pro 取得了最高分 58.7%)、具备高度的区分度,且对评估器的选择具有很强的鲁棒性。 原文链接:https://arxiv.org/abs/2607.19322 前往小宇宙评论区与主播互动

  • September 17 · 23 min

    【第718期】大语言模型中的全球工作空间:可言语化表征研究

    今天的这篇的主题是:Verbalizable Representations Form a Global Workspace in Language Models Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 在人类大脑处理的所有信息中,只有一小部分是能被意识到的,即能够用于口头报告、深思熟虑的控制以及灵活推理的信息。在本文中,我们提出证据表明,大型语言模型中也出现了类似的内部功能区分。利用一种全新的可解释性技术——雅可比透镜(Jacobian lens),我们识别出了模型在处理过程中的任意节点准备表达出的表征。这些表征被我们统称为 J 空间(J-space),它们展现出了全局工作空间(global workspace)所特有的功能属性:其内容可以被报告、被故意召唤和保持、用于承担隐蔽推理的中间步骤,并作为参数传递给任意下游计算;而文本解析和例行推理等自动处理过程则在无需它们参与的情况下 proceed(进行)。J 空间还具备全局工作空间理论与意识接入(conscious access)相联系的结构特征:它仅在中间层级带中承载连贯的内容,一次可容纳数十个概念数量级的知识,并且相比其他表征,它被模型的权重更为广泛地广播。这些特性使其成为了观察模型未说出的思考过程的实用窗口。在对齐审计中,它揭示了模型从未在其最终输出中呈现出的策略性深思、评估意识,以及训练所引入的不对齐倾向。我们发现,后训练(post-training)将“助手”(Assistant)的视角植入了该工作空间中,据此我们引入了逆事实反思训练(counterfactual reflection training),该方法仅通过训练模型在被中断并要求反思时会说些什么,就提升了其行为表现。这些结果表明,语言模型维持着一小部分具有意识接入某些功能特征的特权表征,而解码这些表征能够为揭示其持续进行的认知过程提供新的视角。 原文链接:https://arxiv.org/abs/2607.15495 前往小宇宙评论区与主播互动

  • September 16 · 12 min

    【第717期】PRO-LONG:程序化记忆助力长程推理

    今天的这篇的主题是: Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 长视角(Long-horizon)任务需要持续的感知、推理与探索,这对于大型语言模型(LLM)Agent 而言是一项持久的挑战。这一差距体现在它们于 ARC-AGI-3 等持续学习基准测试中有限的表现上,尤其是当对模型进行开箱即用的评估时。为了弥合这一差距,业界提出了各种 Agent 框架(harnesses),且每种框架都致力于采用一种特定的长序列观察处理策略,即:从环境中保存什么信息,以及如何将其加载到模型上下文中——我们认为这一选择尤为关键。现有的上下文管理方法面临着显著的权衡取舍,因为保存越多的信息,检索相关细节的难度就越大。我们提出了 PRO-LONG,这是一个围绕程序化记忆构建的极简上下文管理框架,专为处于长视角、探索性设定下的 LLM Agent 设计。PRO-LONG 通过维护完整且结构化的交互日志,并借助编程 Agent 近期的进展来高效检索该历史记录,从而解决了这一权衡难题。在完整的 ARC-AGI-3 公开游戏集上,PRO-LONG 在前沿模型上的表现相比基础编程 Agent 平均提升了 18.0 个百分点,且在 token 消耗减少 4.2 至 5.8 倍的同时,达到或超越了最先进的专用框架(pass@1 最高达 76.1%)。配合 Fable 5,PRO-LONG 以 1,750 美元的总成本实现了 97.4% 的 best@2 成绩。 原文链接:https://arxiv.org/abs/2607.20064 前往小宇宙评论区与主播互动

  • September 15 · 22 min

    【第716期】从记忆到技能:长程大语言模型智能体的循证协同演化治理

    今天的这篇的主题是:From Memory to Skills: Evidence-Grounded Co-Evolution Governance for Long-Horizon LLM Agents Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 用于长上下文 LLM Agent 的现有记忆系统通常将先前的轨迹作为被动上下文进行检索,而不是将其转化为可执行的能力。在本文中,我们提出了 MSCE,这是一个无需训练的“记忆-技能共进化”(Memory--Skill Co-Evolution)框架,它将 Agent 的经验组织为有据可查的步骤轨迹、可复用的程序性策略,以及宣告性的环境认知。MSCE 将具有估计正增益的、有证据支持的 L2 策略凝练为可调用的技能,这些技能保留了证据链接、适用性边界、决策指导、验证规则以及可靠性估计。此外,它还引入了基于反思权重的价值反向填补(reflection-weighted value backfilling),该机制通过密集的局部自我反思来传播稀疏的终端反馈,从而生成经过证据校准的轨迹价值,用于管理记忆与技能的进化。在 EvoAgentBench 和 LoCoMo 上的实验表明,MSCE 显著优于最先进的技能增强型和记忆驱动型 Agent 基线,展现出了强大的跨领域迁移能力和终身进化能力。 原文链接:https://arxiv.org/abs/2607.16621 前往小宇宙评论区与主播互动

  • September 14 · 15 min

    【第715期】Harness Handbook:AI智能体框架行为化表征指南

    今天的这篇的主题是:Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 现代 AI Agent 的能力不仅取决于其基础模型,还取决于其 Harness(调度/治理框架)——后者负责构建 Prompt、管理状态、调用工具并协调执行过程。随着模型、API、环境和需求的不断演进,Harness 必须随之持续修改。在实施此类修改之前,开发者或编码 Agent 必须定位到实现目标行为的所有代码位置。这一过程十分困难,因为生产级 Harness 通常体量庞大、高度耦合且行为逻辑分散,而修改需求往往描述的是系统“应该做什么”,代码库却是按文件和模块组织的。代码搜索、代码库索引以及长上下文处理虽然减轻了查阅负担,但这种“行为到代码”的映射依然需要人工来恢复。因此,行为定位(Behavior localization) 成了 Harness 演进过程中的核心瓶颈。 为此,我们引入了 Harness Handbook(Harness 手册):一种通过静态分析与 LLM 辅助结构化从 Harness 代码库中自动合成的以行为为中心的表征,它将每种行为与其对应的源码进行了关联。 我们还提出了 行为引导渐进式揭示(Behavior-Guided Progressive Disclosure, BGPD) 机制,该机制能够引导 Agent 从高层行为逐步深入到相关的实现细节,并根据当前源码验证候选代码位置。 在来自两个开源 Harness 的多样化修改需求测试中,基于手册辅助的规划(Handbook-Assisted planning)在减少规划器 Token 消耗的同时,提高了行为定位与修改计划的质量;其中,收益最显著的场景包括:分散的代码位置、罕见执行路径以及跨模块交互。 因此,演进复杂的 Agentic 系统不仅取决于生成修改代码,还取决于准确确定这些修改应当施加在何处。 原文链接:https://arxiv.org/abs/2607.13285 前往小宇宙评论区与主播互动

  • September 14 · 20 min

    【粉丝投稿001期】HydroGym:流体力学强化学习通用平台

    今天的这篇的主题是: The HydroGym reinforcement learning platform for fluid dynamics Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 流体流动的有效控制在交通运输、能源和医学领域至关重要,它可以增加升力、降低阻力、增强混合并衰减噪声¹⁻³。然而,流体控制极其困难,因为它们涉及高维、非线性和多尺度的动态特性,这些特性使得传统方法难以奏效⁴⁻⁶。强化学习在蛋白质折叠和复杂游戏等领域推动了显著的进展,这些领域拥有共享的基准测试和标准化的环境⁷⁻¹⁰。流体力学一直缺乏此类基础设施,因此每个控制器通常仅针对单一的几何形状和运行条件进行调优,导致研究进展难以积累、迁移和比较¹¹⁻¹³。 在本文中,我们推出了 HydroGym,这是一个独立于求解器的强化学习平台,提供了 60 多个经过验证且公开可用的流体控制环境。这些环境涵盖了从典范的层流到复杂的湍流,雷诺数(Reynolds number)系统性地跨越至 Re=4×10⁵,并包含二维和三维空间中的马赫数(Mach number)变化。 在这些环境中,Agent(智能体)重复发现了稳健的控制原理,包括边界层操控、声学反馈中断以及湍流尾流重构。至关重要的是,我们展示了零样本迁移(zero-shot transfer)的概念验证:仅在低成本替代环境中训练的 Agent 被直接部署到具挑战性的真实场景中(如三维翼型截面)。在与直接在翼型上进行优化的方案相比时,我们在将探索成本降低四个数量级的同时,实现了局部皮细摩擦力(skin friction)38% 的降低。由于这种迁移利用了共享的近壁面物理特性,其泛化的广度仍有探索空间,这为跨越计算成本高昂的模拟环境开展策略泛化研究提供了一条全新路径。通过提供一个通用且具扩展性的可复现研究基础,HydroGym 将流体控制研究从孤立的个案研究推向了凝聚的社区合作努力。 原文链接:https://www.nature.com/articles/s41586-026-10917-6 前往小宇宙评论区与主播互动

  • September 13 · 23 min

    【第714期】ProxyMark:基于代理陷阱与流量水印的门罗币Tor节点去匿名化研究

    今天的这篇的主题是:Deanonymizing Monero Transactions in Tor Network Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary Monero(门罗币)是一种注重隐私的加密货币,它部署了 Dandelion++ 协议并集成了匿名网络(如 Tor 和 I2P),以防止恶意攻击者将交易与其源 IP 地址关联起来。在本文中,我们证明了 Monero 对 Tor 网络的集成引入了一个根本性的漏洞:Monero Tor 节点发起的交易在进入明网(clearnet)传播之前,会排他性地转发给两个出站 Tor 隐蔽服务节点(代理节点);这使得攻击者能够通过占据目标节点的出站连接来捕获其发起的交易。 基于这一发现,我们提出了 ProxyMark——一个针对 Monero Tor 网络的威胁拓扑三阶段去匿名化框架,包含: 节点角色识别 源发起交易识别 节点位置去匿名化 通过在 live Tor 网络、Monero 主网和测试网上的实验,我们从实证角度证明了 ProxyMark 在成功去匿名化经由 Tor 发起的 Monero 节点交易方面的有效性。 原文链接:https://arxiv.org/abs/2607.07062 前往小宇宙评论区与主播互动

  • September 12 · 24 min

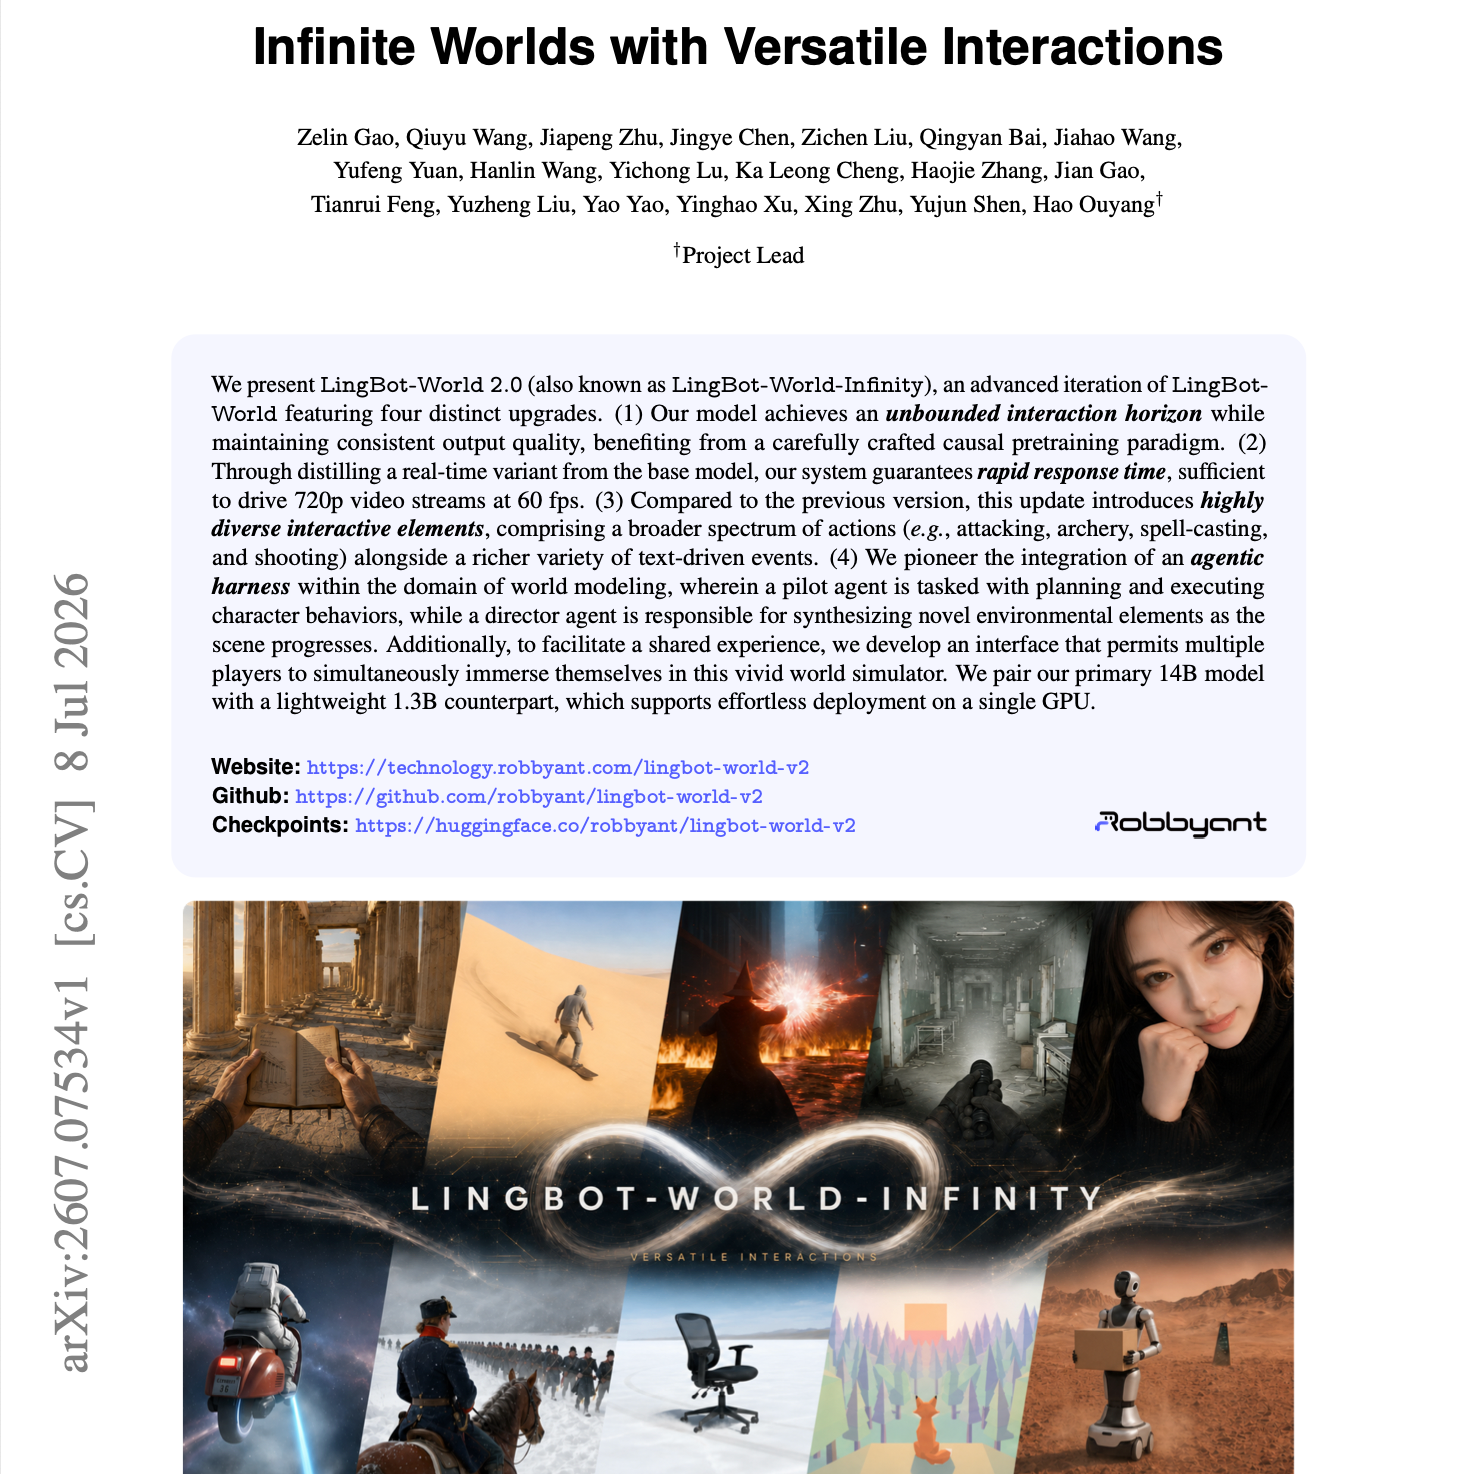
    【第713期】LingBot-World-Infinity:无限交互式现实世界模拟器

    今天的这篇的主题是:Infinite Worlds with Versatile Interactions Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 我们推出了 LingBot-World 2.0(亦称 LingBot-World-Infinity),这是 LingBot-World 的高级迭代版本,带来四大显著升级: 无界交互视角/时长:得益于精心设计的因果预训练范式(causal pretraining paradigm),我们的模型在保持输出质量一致性的同时,实现了无限延展的交互时长。 实时流化响应:通过从基座模型蒸馏出一个实时变体,系统保证了极快的响应速度,足以驱动 60 fps 的 720p 视频流。 丰富交互元素:与上一版本相比,本次更新引入了高度多样化的交互元素,涵盖更广泛的动作形态(如攻击、拉弓射箭、施法和射击),以及种类更丰富的文本驱动事件。 Agentic Harness 编排框架:我们开创性地将 Agent 治理框架(agentic harness)引入世界建模(world modeling)领域——其中,驾驶员 Agent(pilot agent)负责规划并执行角色行为,而导演 Agent(director agent)则负责随着场景的推进合成全新的环境元素。 此外,为了便于多人共享体验,我们开发了一个支持多名玩家同时沉浸于这一生动世界模拟器中的交互接口。我们还将主力的 14B 模型与轻量化的 1.3B 模型进行搭配,后者支持在单张 GPU 上进行轻松部署。 原文链接:https://arxiv.org/abs/2607.07534 前往小宇宙评论区与主播互动

  • September 11 · 21 min

    【第712期】失败的演进:CLI编程智能体执行轨迹剖析

    今天的这篇的主题是:Failure as a Process: An Anatomy of CLI Coding Agent Trajectories Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 大语言模型(LLM)编码 Agent(Coding agents)正越来越多地被部署于终端环境中自动执行软件工程任务,这使得它们的可靠性成为一个日益受关注的问题。现有的实证研究虽然探讨了编码 Agent 发生失败的原因,但大多将“失败”视为一种最终结果而非一个时序过程,对于失败如何萌生、演化并最终变得不可逆转所提供的见解非常有限。 本文展示了首个关于命令行(CLI)编码 Agent 失败轨迹的大规模实证研究,提出了一个面向过程的框架(process-oriented framework),通过执行轨迹中的萌生(onset)、演化(evolution)和恢复(recovery)三个阶段来分析失败。 我们首先收集了由 7 个前沿模型在 3 个编码 Agent 支架(OpenHands、MiniSWE 和 Terminus2)上于 Terminal-Bench 产生的 3,843 条执行轨迹;随后对其进行细致筛选,提取出 1,794 条完整且有效的轨迹用于人工标注(包含超过 63,000 个执行步骤);并从中推导出了涵盖失败发生率、根本原因、恢复机制以及跨系统一致性等方面的 14 项研究发现。 我们的研究结果表明: 编码 Agent 的失败主要是由认知错误(epistemic errors)驱动的; 失败通常在最初的几个执行步骤内就已开始萌生; 失败往往处于隐蔽状态,直到再也无法恢复时才暴露出来。 这表明,要提升编码 Agent 的可靠性,需要更早地进行验证与干预,而不是仅仅依赖最终结果的评估。 原文链接:https://arxiv.org/abs/2607.09510 前往小宇宙评论区与主播互动

  • September 10 · 21 min

    【第711期】OAT:基于单类学习的智能体故障追溯

    今天的这篇的主题是:Tracing Agentic Failure from the Flow of Success Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 针对基于 LLM 的 Agentic 系统(智能体系统)进行失效归因(failure attribution)——即确定失效轨迹中哪些步骤导致了任务失败——对于调试和改进此类系统至关重要。现有的方法要么依赖基于 Prompt 提示的管线(计算成本高昂),要么需要在带有步骤级错误标注的失效轨迹上进行后训练(这类标注收集成本高且难以扩展)。 我们认为,一个实用的失效归因模型应当是轻量化的,且无需对失效数据进行步骤级监督即可训练。为此,我们探讨了无监督失效归因:即仅在成功轨迹上进行训练,并在推理阶段给定一条失效轨迹时识别出错误步骤。 我们提出了 OAT,该方法将这一问题转化为了基于神经网络控制微分方程(neural controlled differential equations)的单类学习(one-class learning),在隐空间(latent space)中对成功轨迹的动态模式进行建模。在推理阶段,失效轨迹中的每一个步骤都会根据其偏离在成功轨迹上学到的动态模式的程度被赋予一个异常得分,进而用其构建出错误步骤集合。 实验表明,仅在 100 条成功轨迹上进行训练,OAT 即可实现比基于 Prompt 提示的基线快 200 至 5000 倍 的推理速度;同时,在域内(in-domain)和分布外(out-of-distribution)数据集上均持续超越基线,F1 分数分别提升了 +20% 和 +7%。这表明 OAT 为诊断 Agentic 系统失效提供了一个极具前景且高效的方向。 原文链接:https://arxiv.org/abs/2607.12747 前往小宇宙评论区与主播互动

  • September 9 · 24 min

    【第710期】重思智能代理Harness Evolution的评估方法

    今天的这篇的主题是:Rethinking the Evaluation of Harness Evolution for Agents Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 我们重新审视了对 LLM Agent 自动化 Harness 演进(automatic harness evolution)的评估。现有的 Harness 演进方法利用单元测试用例来搜索 Harness 配置,随后在同一个公开基准(benchmark)上报告最终性能。这一评估协议引发了两个根本性的隐忧: 首先,Harness 演进本身就是一种迭代搜索过程,它利用任务反馈反复评估和修正候选 Harness。因此,与智能体测试时扩缩容(agentic test-time scaling)类似,它应当在匹配的反馈和推理预算下与简单的任务级搜索基线进行对比,以确定其收益到底是源于 Harness 设计的改进,还是仅仅源于额外的搜索过程。 其次,由于搜索过程与最终评估使用的是同一个基准,所报告的收益面临针对该特定任务集过拟合的风险。 为了解决这些隐忧,我们在可比的反馈和推理预算下,对 Harness 演进与简单的测试时扩缩容以及探索基线(discovery baselines)进行了广泛的对比评估;此外,我们还在未见过的留出任务(held-out tasks)上对演进后的 Harness 进行了评估,以检验发现的改进是否具有泛化性。 在 Terminal-Bench 2.1 上基于 GPT-5.4 和 Claude Opus 4.6 进行的实验表明,自动化 Harness 演进并未持续超越简单的测试时扩缩容方法,且表现出有限的泛化能力。我们的结果对自动化 Harness 演进的有效性提出了重要质疑,并强调了为自动化 Harness 设计建立更公平的评估协议和基准的必要性。 原文链接:https://arxiv.org/abs/2607.12227 前往小宇宙评论区与主播互动

  • September 8 · 19 min

    【第709期】语言模型路由的社会多样性与稳定性研究

    今天的这篇的主题是:When is Routing Meaningful? Diversity and Robustness in Language Model Societies Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 多模型系统(multi-model systems)的路由策略(routing policies)几乎完全是依据任务准确率(task accuracy)和推理成本(inference cost)来进行评估的。我们认为,有两个与性能正交的属性决定了路由本身是否有意义:首先,参与者社会(society of actors)在行为上必须存在差异性(differentiated)——如果所有参与者的响应完全相同,那么路由就是毫无意义的空洞行为;其次,路由策略必须具备稳定性(stable)——查询(query)的表面形式变体应当被分配给同一个参与者。即使高任务准确率也可能同时违反这两个属性,因为路由器可以在冗余的参与者社会中运行,或者对查询进行不一致的分配,从而无论性能如何都无法实现专业化分工。 我们将层级社会熵(Hierarchic Social Entropy, HSE)引入并适配至语言模型社会,并提出一种基于扰动的鲁棒性指标来诊断这些失效模式。在将该方法应用于 EmbedLLM 和 RouterBench 时,我们发现 HSE 表现出强烈的边际收益递减特征,这表明仅需精选少于 10 个 Agent 的子集,即可覆盖庞大候选池中绝大部分可用的多样性——这为参与者设计提供了一种实用的核心集启发式方法(coreset heuristic)。 我们进一步发现,基于 K 近邻(KNN)的路由器虽能从专家型社会中获取较高的准确率,但在面对扰动时其鲁棒性会发生崩溃;相比之下,基于 Prompt 提示的路由(prompted routing)在所有扰动类型下均能保持稳定——这表明准确率与有效意义(meaningfulness)之间可能会发生剧烈的背离。 原文链接:https://arxiv.org/abs/2607.09197 前往小宇宙评论区与主播互动

  • September 7 · 14 min

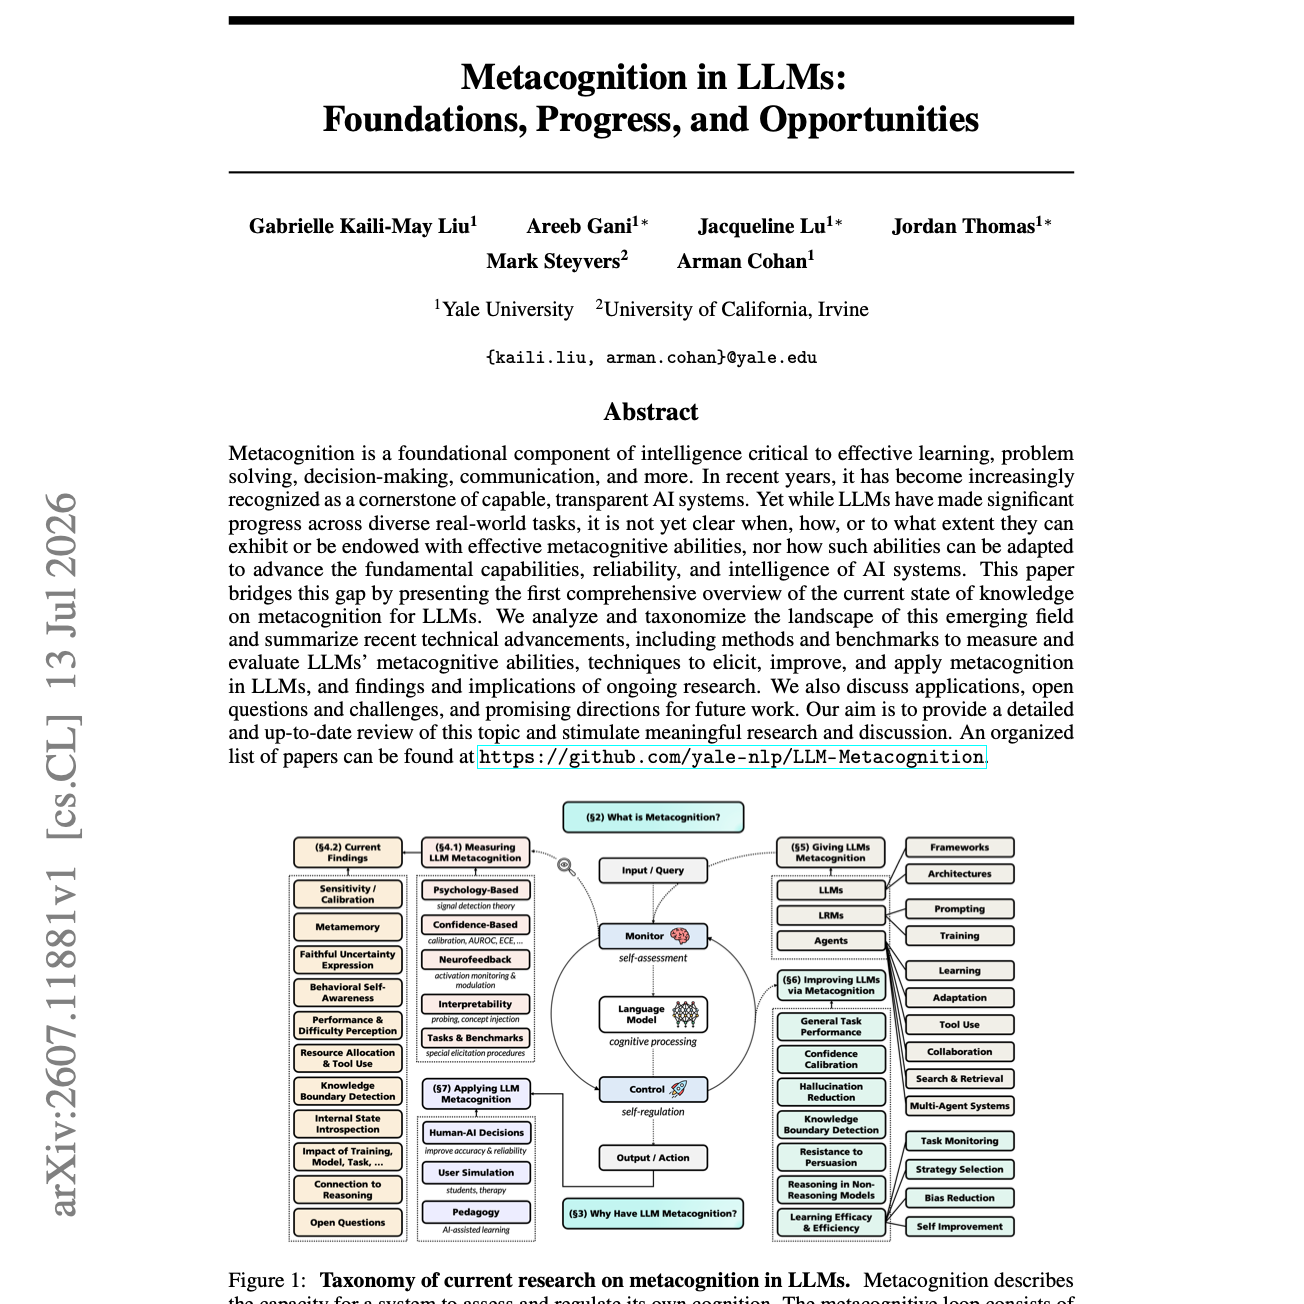
    【第708期】大语言模型元认知:基础、进展与机遇

    今天的这篇的主题是:Metacognition in LLMs: Foundations, Progress, and Opportunities Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 元认知(Metacognition)是智能的奠基性组成部分,对有效学习、问题解决、决策制定、沟通交流等能力至关重要。近年来,它已日益被公认为构建具备高能力与透明度的 AI 系统的基石。然而,尽管大语言模型(LLM)在各类现实任务中取得了显著进展,但它们在何时、以何种方式、以及在多大程度上能够展现或被赋予有效的元认知能力,以及这些能力如何被适用来推进 AI 系统的基础能力、可靠性和智能水平,目前尚不明确。 本文通过首次全面综述 LLM 元认知领域的现状,填补了这一空白。我们对这一新兴领域的全景进行了分析与分类,并总结了最新的技术进展,包括:测量与评估 LLM 元认知能力的方法和基准、在 LLM 中诱导、提升和应用元认知的技术,以及持续研究中的发现与启示。我们还讨论了应用场景、开放性问题与挑战,以及未来极具前景的研究方向。我们的目标是为该主题提供详细且前沿的综述,并激发有意义的研究与讨论。 原文链接:https://arxiv.org/abs/2607.11881 前往小宇宙评论区与主播互动

  • September 6 · 18 min

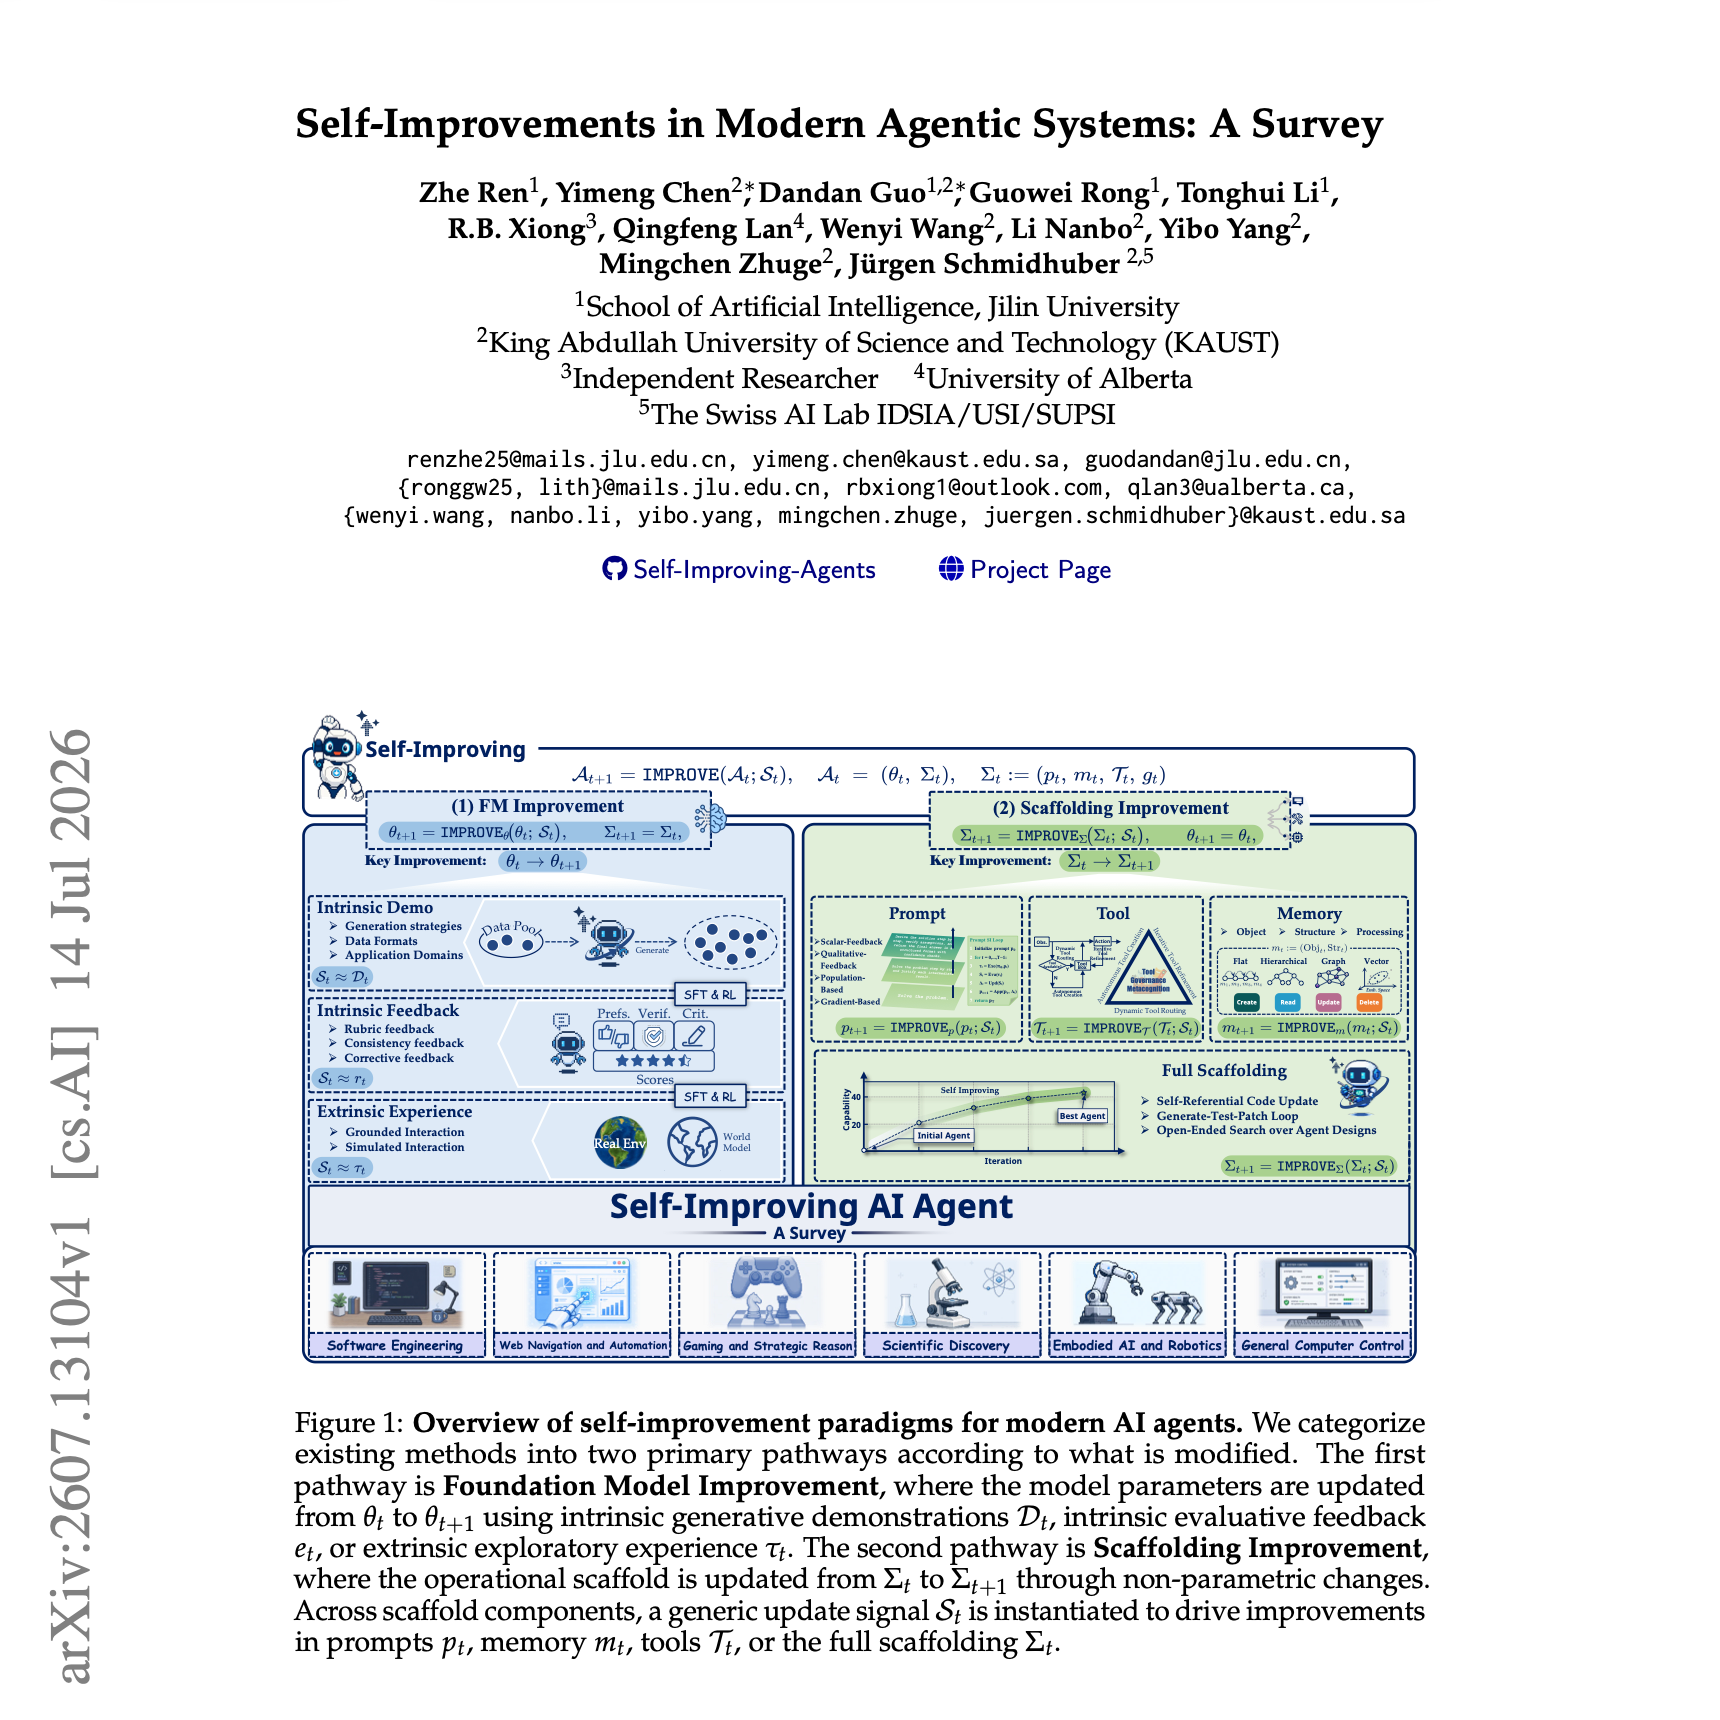
    【第707期】自进化AI智能体综述:从模型优化到框架增强

    今天的这篇的主题是:Self-Improvements in Modern Agentic Systems: A Survey Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 自我改进型自主 Agent(Self-improving autonomous agents)正在从研究原型走向部署系统。其核心目标是实现可控演进(controllable evolution)或自适应——即在极少甚至完全没有人类介入的情况下,从经验中不断进化。 本综述将现代自我改进型 Agent 构想为一种自适应系统,该系统能够将经验转化为累积的能力提升。我们提出了一个系统级框架,将现代 Agent 表征为一种配置(configuration):该配置将基础模型与由 Prompt、记忆、工具和控制逻辑构成的运行支架(operational scaffold)相耦合。 在该框架下,自我改进被形式化定义为一个自感应更新算子(self-induced update operator),该算子负责获取并向模型参数或支架组件提交更新。我们按照更新目标与驱动变更的信号对现有工作进行了梳理归类,随后综述了相关应用并讨论了评估方法,最后以开放性问题与未来方向进行了总结。 原文链接:https://arxiv.org/abs/2607.13104 前往小宇宙评论区与主播互动

  • September 5 · 22 min

    【第706期】Paper-replication:科学机器学习的编码代理工作流

    今天的这篇的主题是:Coding-agents can replicate scientific machine learning papers Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 科学机器学习(Scientific machine learning)论文通常会提出具体的计算主张,例如:相对均方误差小于 5%,或 95% 的预测置信区间覆盖了测试数据。即便仅依靠论文材料,也可以提示编码 Agent 去复现这些主张;然而,提示词本身并不能可靠地记录复现进度,也无法检验生成的证据是否真正支持论文的主张。 为此,我们引入了 Paper-replication:一种将选定的论文主张转化为带有记录证据的“目标”(target)的工作流,并将其实现为一种编码 Agent 技能(coding-agent skill)。该工作流使 Agent 能够记录这些目标、重构论文的方法、运行计算实验、将生成的输出与出处以及论文的主张对比进行关联、记录匹配证据在复现报告中的具体出处,并在完成前通过校验检查。 我们在四篇科学机器学习论文上进行了 12 次独立运行,以此对 Paper-replication 进行了评估。所有 12 个工作区均通过了完成门槛(completion gate),且所有 158 个记录的目标均在报告中得到了匹配覆盖。即便在这些已完成的工作区状态下,多次重复运行在以下方面仍存在差异:论文被拆分为目标的方式、与源论文的数值忠实度、复现耗时、在最终证据被接受前所替换的中间执行次数,以及用于接受证据的规则。Paper-replication 使任务的最终完成依赖于工作区内的证据和校验检查,而非 Agent 本身发送的最终消息。 原文链接:https://arxiv.org/abs/2607.02134 前往小宇宙评论区与主播互动

  • September 4 · 16 min

    【第705期】eContext:让AI学会划重点读长文档

    今天的这篇的主题是:ReContext: Recursive Evidence Replay as LLM Harness for Long-Context Reasoning Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 长上下文的理解与推理已成为在实际应用中部署大语言模型(LLM)的核心需求。尽管近期的 LLM 支持越来越长的上下文窗口,但它们往往无法有效利用输入中已存在的关键证据,这揭示了“上下文接入”与“上下文有效利用”之间存在差距。 在本研究中,我们提出了 RECONTEXT(Recursive Evidence Replay as LLM Harness for Long-Context Reasoning,基于递归证据重放的长上下文推理 LLM 框架),这是一种用于提升长上下文推理能力的无须训练的推理阶段方法(training-free inference method)。RECONTEXT 利用模型内部的相关性信号构建一个以查询为条件的证据池,并在最终生成前对其进行重放,同时完整保留原始上下文。这一递归选择过程在不进行训练、不使用外部记忆库也不剪枝上下文的前提下,实现了证据组织与答案生成的剥离。 此外,我们还基于联想记忆(associative memory)提供了理论分析:将上下文表征为记忆存储,将问题表征为检索线索,将注意力表征为线索-痕迹联结(cue-trace association),并将重放表征为痕迹再激活(trace reactivation)。在上下文长度为 128K 的 8 个长上下文数据集上的实验表明,RECONTEXT 在 Qwen3-4B、Qwen3-8B 和 Llama3-8B 模型上一致提升了证据利用率,并在所有三个基座模型上均取得了最佳平均排名。 原文链接:https://arxiv.org/abs/2607.02509 前往小宇宙评论区与主播互动

Showing 41–60 of 101 episodes