Skip to content
Artwork for Seventy3
Seventy3 · September 15 · 22 min

【第716期】从记忆到技能:长程大语言模型智能体的循证协同演化治理

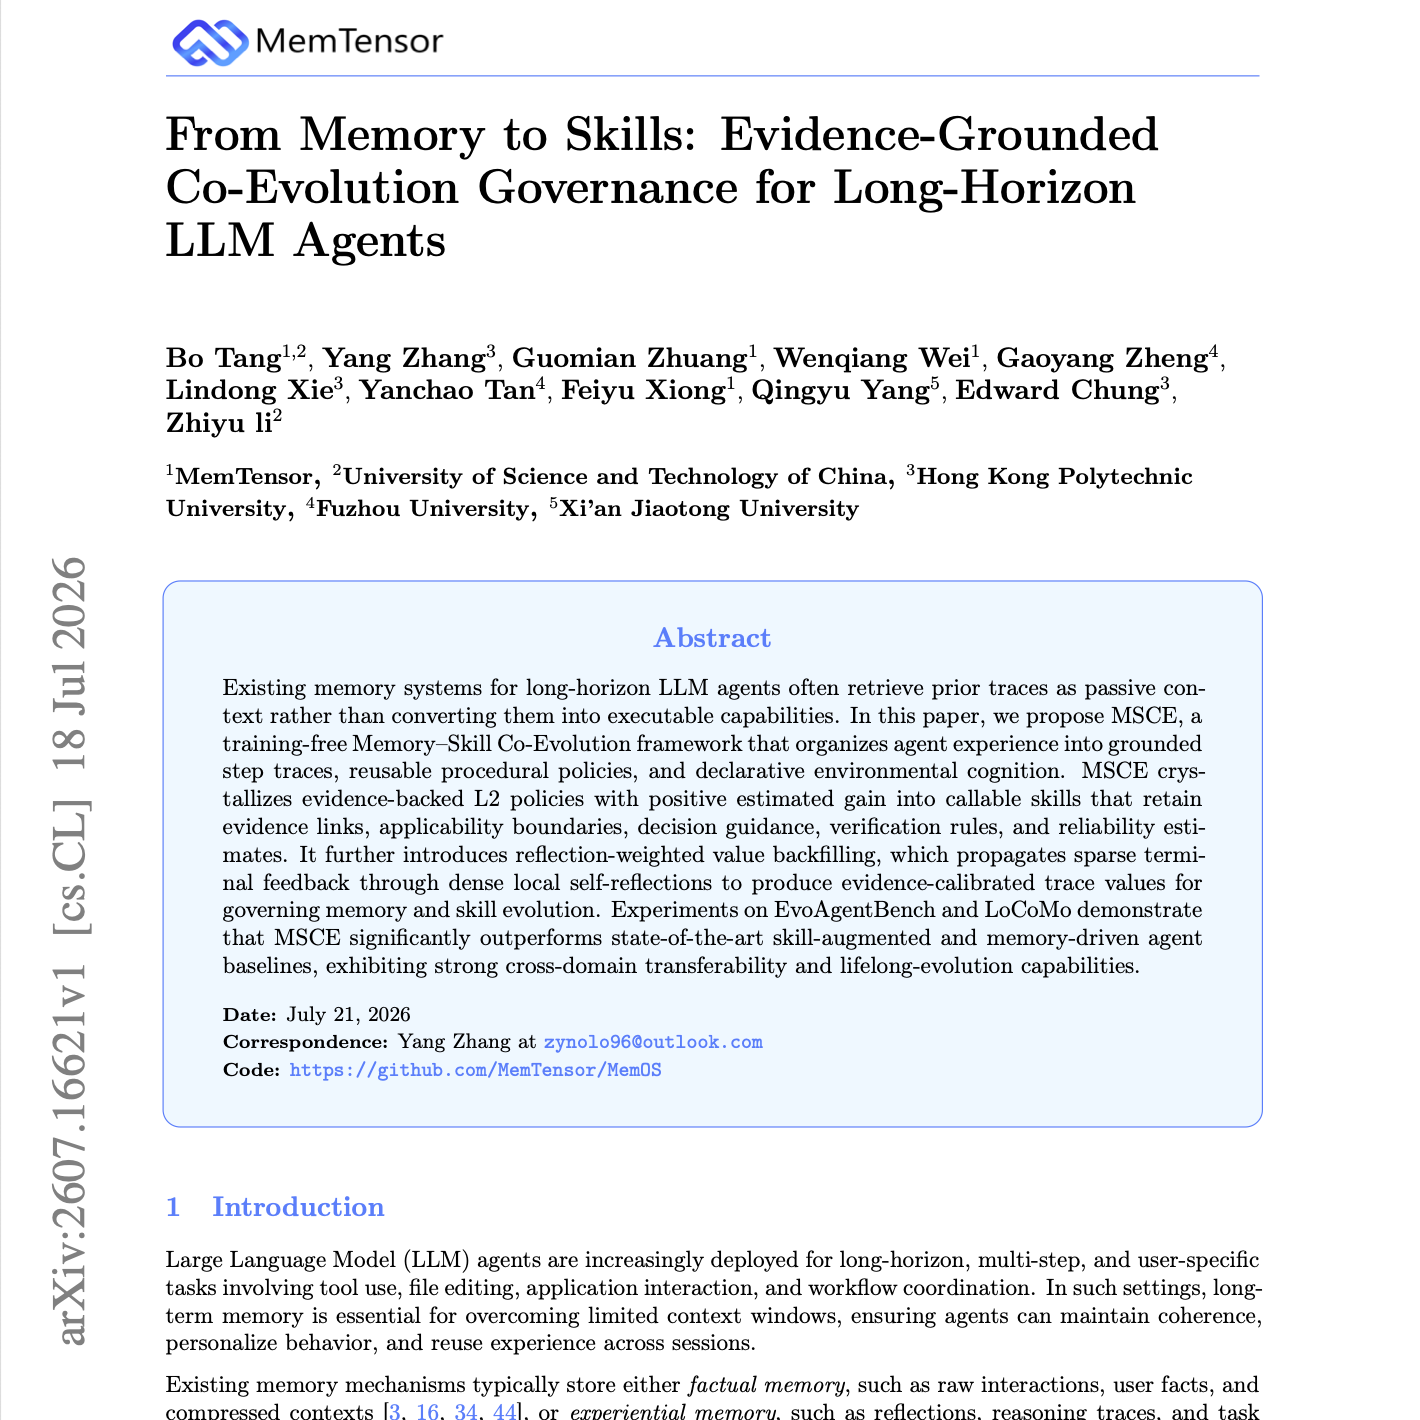
今天的这篇的主题是:From Memory to Skills: Evidence-Grounded Co-Evolution Governance for Long-Horizon LLM Agents Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 用于长上下文 LLM Agent 的现有记忆系统通常将先前的轨迹作为被动上下文进行检索,而不是将其转化为可执行的能力。在本文中,我们提出了 MSCE,这是一个无需训练的“记忆-技能共进化”(Memory--Skill Co-Evolution)框架,它将 Agent 的经验组织为有据可查的步骤轨迹、可复用的程序性策略,以及宣告性的环境认知。MSCE 将具有估计正增益的、有证据支持的 L2 策略凝练为可调用的技能,这些技能保留了证据链接、适用性边界、决策指导、验证规则以及可靠性估计。此外,它还引入了基于反思权重的价值反向填补(reflection-weighted value backfilling),该机制通过密集的局部自我反思来传播稀疏的终端反馈,从而生成经过证据校准的轨迹价值,用于管理记忆与技能的进化。在 EvoAgentBench 和 LoCoMo 上的实验表明,MSCE 显著优于最先进的技能增强型和记忆驱动型 Agent 基线,展现出了强大的跨领域迁移能力和终身进化能力。 原文链接:https://arxiv.org/abs/2607.16621 前往小宇宙评论区与主播互动

0:00-22:43

transcript

No transcript — this publisher did not publish one.

show notes

今天的这篇的主题是:From Memory to Skills: Evidence-Grounded Co-Evolution Governance for Long-Horizon LLM Agents

Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。

如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。

联系小助手微信:seventy3_podcast(加群/投稿论文)

Summary

用于长上下文 LLM Agent 的现有记忆系统通常将先前的轨迹作为被动上下文进行检索,而不是将其转化为可执行的能力。在本文中,我们提出了 MSCE,这是一个无需训练的“记忆-技能共进化”(Memory--Skill Co-Evolution)框架,它将 Agent 的经验组织为有据可查的步骤轨迹、可复用的程序性策略,以及宣告性的环境认知。MSCE 将具有估计正增益的、有证据支持的 L2 策略凝练为可调用的技能,这些技能保留了证据链接、适用性边界、决策指导、验证规则以及可靠性估计。此外,它还引入了基于反思权重的价值反向填补(reflection-weighted value backfilling),该机制通过密集的局部自我反思来传播稀疏的终端反馈,从而生成经过证据校准的轨迹价值,用于管理记忆与技能的进化。在 EvoAgentBench 和 LoCoMo 上的实验表明,MSCE 显著优于最先进的技能增强型和记忆驱动型 Agent 基线,展现出了强大的跨领域迁移能力和终身进化能力。

原文链接:https://arxiv.org/abs/2607.16621


前往小宇宙评论区与主播互动
links2