Skip to content
Artwork for Seventy3
TechnologyEducationScience

Seventy3

任雨山

73播客,Sheldon最喜欢的数字,内容均为Google NotebookLM原生生成,每天由AI领读最新的前沿论文。欢迎投稿合作。

Play
  • 90 episodes
  • daily
  • Avg 19 min
  • Chinese
Counted on this page — what you have heard stays on this device, so it is not something the list can be paged by.
  • October 1 · 14 min

    【第732期】智能体故障定位的交互中心分类法

    今天的这篇的主题是: Model or Harness? An Interaction-Centric Taxonomy for Localizing Agent Failures Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 现有评估通常将智能体(agent)的失败归结为系统层面的结果,掩盖了故障的始发位置以及哪种干预措施能够改进智能体系统。这就引发了一个“修复分配问题”(repair-assignment problem):相同的显性失败可能因其根源不同,分别需要模型后训练(post-training)、框架工程(harness engineering)、环境重构或基准测试修复。由于智能体行为是由模型、框架、用户、工具、记忆和环境之间的相互作用涌现而来的,因此结果层面的标签通常不足以指导改进。大多数失败分类法对解决这一问题的帮助微乎其微,因为它们依赖于特定的基准测试且缺乏统一的结构。我们提出了一种以交互为中心的分类法(interaction-centric taxonomy),该方法将失败准确定位至其发生的交互过程,并识别出相应的责任组件。该分类法整理了 41 种失败模式,将每种模式分别归属于两个组件之间的连接边,并指定了指示修复归属的故障方(fault side)。这使得该分类法具备了可操作性:模型侧的失败指明了后训练的目标;框架侧的失败指向了脚手架(scaffolding)与工具集成的修复;而环境或评分器(grader)的失败则揭示了需要重新设计的评估条件。该模式适用于各种智能体架构,从代码助手到长流程个人助手以及多智能体系统。我们通过来自公开基准测试、模型系统卡(system cards)、已发表报告和记录的智能体轨迹中的具体示例对该分类法进行了奠基,并使用独立的推理智能体作为裁判评估了其可复现性。在涵盖 4 个前沿模型的测试中,最强裁判对人类类别标签的一致性系数达到了 Cohen's κ=0.76,这表明这些类别捕捉到了公认的结构特征,而非特定标注者的偏好。 原文链接:https://arxiv.org/abs/2607.28802 前往小宇宙评论区与主播互动
  • September 30 · 16 min

    【第731期】AgentThread:大模型代理协议的形式化安全分析与验证

    今天的这篇的主题是: Formal Security Analysis of Agent Protocol Composition Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary AI 智能体协议定义了智能体如何使用工具、委托工作以及在不同软件系统间进行协调,但它们的安全需求仍不完善,且在不同部署中的执行情况也并不一致。我们提出了 AgentThread,这是一个源链式(source-linked)框架,用于对智能体协议进行从规范文本到运行中 SDK 的安全保证分析。AgentThread 贡献了一个分层的安全范畴,将源自协议的检查形式化为 TLA+ 约束不变式,并提供了一个双阶段检查器——该检查器能将协议规范编译为可进行模型检验的模型,并通过协议适配器针对真实 SDK 重放可执行的反例。对于每一项发现,AgentThread 都会记录检查背后的源文本,并将被违反的协议需求与缺失的建议、加固缺陷以及未分配的跨协议责任区分开来。 在涵盖 5 个新兴智能体协议的测试中,AgentThread 识别出了 35 个规范层面的发现,通过对生产级 SDK 和参考服务器进行的 80 个实现测试对其提供了支持,并发现了仅在协议组合下才会出现的 30 个额外失效案例。我们进一步表明,实际上仅有一个协议执行了与安全相关的控制,且没有协议为跨协议行为分配执行责任。因此,智能体协议的不安全性不仅是一个规范或实现问题,也是跨协议、SDK 和部署的责任鸿沟。 原文链接:https://arxiv.org/abs/2606.28690 前往小宇宙评论区与主播互动

  • September 29 · 28 min

    【第730期】InterSAGE:智能体互联网的安全性与可验证互操作协议

    今天的这篇的主题是: InterSAGE: The Secure and Verifiable Interoperability Protocol for An Internet of Agents Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 新兴的智能体互联网(Internet of Agents)使基于大语言模型的智能体能够跨越组织边界发现同行、调用工具并委托任务。现有协议越来越多地定义了智能体之间如何交换消息,但并未定义智能体在委托发生后如何证明其身份、授权、宣称的能力或责任归属。我们提出了 InterSAGE,这是一个信任原生的协议套件,它与通信协议并行提供(而非取代)了这一缺失的安全底层。InterSAGE 由四个层级组成:持久身份、发现、信任协商与责任归属。其四大核心原语为:(1)绑定开发者、代码包、运算符和部署上下文的智能体身份卡;(2)使用绑定 DID 的可验证凭证清单进行具备能力感知的发现;(3)将单调能力衰减与双层访问控制相结合的信任协商;以及(4)在无需共识账本的情况下,将使用情况、委托和执行轨迹绑定至智能体身份的内核介导加密审计轨迹。InterSAGE 旨在对 MCP、A2A、ANP 和 AG-UI 进行补充,使通信协议能够独立演进,同时保持信任语义的明确性、可移植性和可验证性。我们将 InterSAGE 与涵盖智能体协议、去中心化身份、OAuth/OIDC 扩展、零信任治理、委托及审计架构的 50 多项相关工作进行了比较。我们表明,先前的架构中没有一种能够将持久身份、能力感知发现、信任协商和责任归属作为统一的四层信任底层来共同执行,以实现安全的智能体互操作性。 原文链接:https://arxiv.org/abs/2608.13030 前往小宇宙评论区与主播互动

  • September 28 · 15 min

    【第729期】Agent文件系统代理存储:组织、演化与可持续性研究

    今天的这篇的主题是: Filesystem-Based Memory for LLM Agents: Organization, Evolution, and Sustainability Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 部署的 LLM 智能体(LLM agents)越来越倾向于将长期记忆以文件系统的形式保存:一个由 Markdown 文件组成的目录树,智能体自身通过通用的文件工具进行读取、写入和重组。然而,学术研究在很大程度上忽略了这一介质:先前的系统通常设计定制化的记忆表示形式并针对其研究检索,使得默认方案的两个关键假设未经检验:即随着记忆的累积、冲突和过时,智能体能够保持一个不断增长的存储库处于有序状态;以及这种组织方式确实能带来收益。本文对基于文件系统的智能体记忆进行了首次系统性探索。我们将该场景正式化为一个围绕单一记忆文件系统展开的三重角色模型:管理智能体负责整合并组织传入的内容,检索智能体负责使用引用来源回答查询,执行智能体则提供任务轨迹并将其提炼为技能,从而在单个存储库中统一了声明性记忆与技能。在长对话基准和具身任务中,随着记忆的增长,我们改变了记忆形态(智能体组织的层级结构、逐字转储、块检索)、流规模、工具套件(沙盒 Shell、记忆工具风格的函数、多样化的搜索工具)以及管理与检索智能体的能力,同时跟踪回答质量、成本和存储库的健康状况。有序组织能可靠带来的优势是搜索经济性:在资料规模庞大时,有序的存储库能使检索成本降低约一半。然而,当今的智能体未能实现默认方案的承诺:在我们的增长研究中,除了最强的管理智能体之外,所有智能体的组织结构都会发生侵蚀;并且我们测试的所有智能体都未能将组织本身转化为更好的回答质量。此外,模型并非决定存储库形态的唯一杠杆:仅更换工具集就能对存储库形态产生与更换模型同样强烈的重塑作用。本研究将文件系统这一默认方案从一项盲目的假设转变为智能体记忆的设计空间。 原文链接:https://arxiv.org/abs/2607.26637 前往小宇宙评论区与主播互动

  • September 27 · 24 min

    【第728期】ACM:面向长时任务的自主语境管理框架

    今天的这篇的主题是: ACM: Agentic Context Management for Long Horizon Tasks Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary Agent 化任务在本质上具有长视角(long-horizon)与多轮交互的特点,会在与环境的互动中不断积累上下文。现有的上下文压缩方法不可避免地会带来信息损失,并且通常由僵化的启发式规则触发,导致它们无法与 Agent 动态演进的推理焦点保持对齐。 我们提出了 Agentic Context Management(ACM,Agent 化上下文管理),这是一个为 Agent 配备专用上下文编辑工具以实现无损上下文管理的框架。受人类短时记忆与长时记忆相互作用的启发,Agent 能够自主决定何时压缩其上下文,将废弃的内容卸载(offload)至外部记忆系统,并在后续需要时根据检索需求对其发起查询。 基于该框架,我们进一步开发了一个后训练(post-training)流水线,用于构建高质量的上下文管理演示数据,并提升模型在 Agent 化搜索与编程任务上的性能。深入分析表明,有效的上下文管理能够减轻峰值 token 压力,支持更深入长久的探索,并在独立试验中产生更加稳定一致的解决方案。代码、数据和模型 Checkpoints 已在该 URL(this https URL)处提供。 原文链接:https://arxiv.org/abs/2607.23809 前往小宇宙评论区与主播互动

  • September 26 · 25 min

    【第727期】JAXBench:自主TPU内核优化评测基准

    今天的这篇的主题是: JAXBench: Benchmarking Autonomous TPU Kernel Optimization Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 严格的基准测试通过确立可供攀登的共同目标,推动了自主 GPU 内核性能优化领域的进步,但 TPU 领域尚无同等效力的基准。我们推出了 JAXBench,这是一个在 Google Cloud TPU 上用于 AI 生成内核优化的 TPU 原生基准测试套件。 JAXBench 包含 50 个既具备实际相关性又留有优化空间(headroom)的 JAX 工作负载。我们从公共 MaxText 库中的架构(如 Llama-3.1、DeepSeek-V3、Mixtral、Mamba-2 和 AlphaFold2)中提取了 17 个生产级 ML 算子,并从 KernelBench 中翻译了 33 个经正确性验证的算子,同时设置了能够实现高 TPU v6e MXU 利用率的新问题规模。在 17 个生产级算子中,有 8 个附带了来自公共 Tokamax 库且经过分块大小调优(block-size tuned)的手工优化 Pallas 内核,以确立专家级上限基线。 我们评估了四种基于反馈的方法在为 JAXBench 生成候选 Pallas 内核上的表现。在配合 Gemini 3 Flash 的全套基准测试中,我们发现对于像 Pallas 这样缺乏丰富文档的 DSL 而言,特定于目标的上下文比模型规模更为关键。提供精心挑选的 TPU 文档上下文,可将单样本正确率(per-sample correctness)从 5.8% 提升至 37.3%,并在 50 个基准测试中解决了 48 个,实现了 1.28 倍的几何平均加速比。 一旦实现正确性,搜索结构就会带来显著收益:Autocomp 的束搜索(beam-search)流水线相比 XLA 达到了 1.36 倍的几何平均加速比。在 8 个手工调优的内核上,Autocomp 相比 XLA 取得了 1.60 倍的几何平均加速比,恢复了 Tokamax 2.08 倍上限的大部分性能,但在专用的分页(paged)和不规则(ragged)注意力算子方面仍稍显逊色。 高质量的 TPU 内核优化仍是一项极具挑战性的任务,我们现发布 JAXBench 基准测试、评估框架(harness)以及基线结果,以支持开源社区的贡献。 原文链接:https://arxiv.org/abs/2607.20466 前往小宇宙评论区与主播互动

  • September 25 · 25 min

    【第726期】Molt:面向代理强化学习的可扩展原生PyTorch训练框架

    今天的这篇的主题是: Molt: A Scalable PyTorch-Native Training Framework for Agentic Reinforcement Learning Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary Agent 化强化学习(Agentic reinforcement learning)研究伴随着频繁的算法修改、全新的估计器(estimators)、新的流水线阶段以及新的采样方案(rollout schemes)。而在主流框架中,每项修改都会穿透训练器(trainer)、分布式后端以及采样胶水层(rollout glue):这种研发成本在每次迭代中都会落到研究人员头上。 Molt 是一个基于 PyTorch 原生构建的训练框架,旨在降低上述成本:其代码库精简且清晰,足以让研究人员将其完全记在脑海中,也足以让 AI 编程助手对其完整代码进行阅读与推理,从而使算法流程能够实现端到端的追踪与修改。在 Molt 中,Agent 就是一个普通的程序,并且通过单个异步循环即可完成多模态与混合专家(Mixture-of-Experts)策略的训练,同时绝不在未生成的 token 上进行训练,在 token、策略版本和模型语义上保持了一致性。 精简并不以牺牲性能为代价:在对齐的完全异步协议下,Molt 在统计学意义上与基于 Megatron 的最先进技术栈相当。Molt 已开源,并在该 URL(this https URL)处提供了 Recipes 与容器配置。 原文链接:https://arxiv.org/abs/2607.21653 前往小宇宙评论区与主播互动

  • September 24 · 13 min

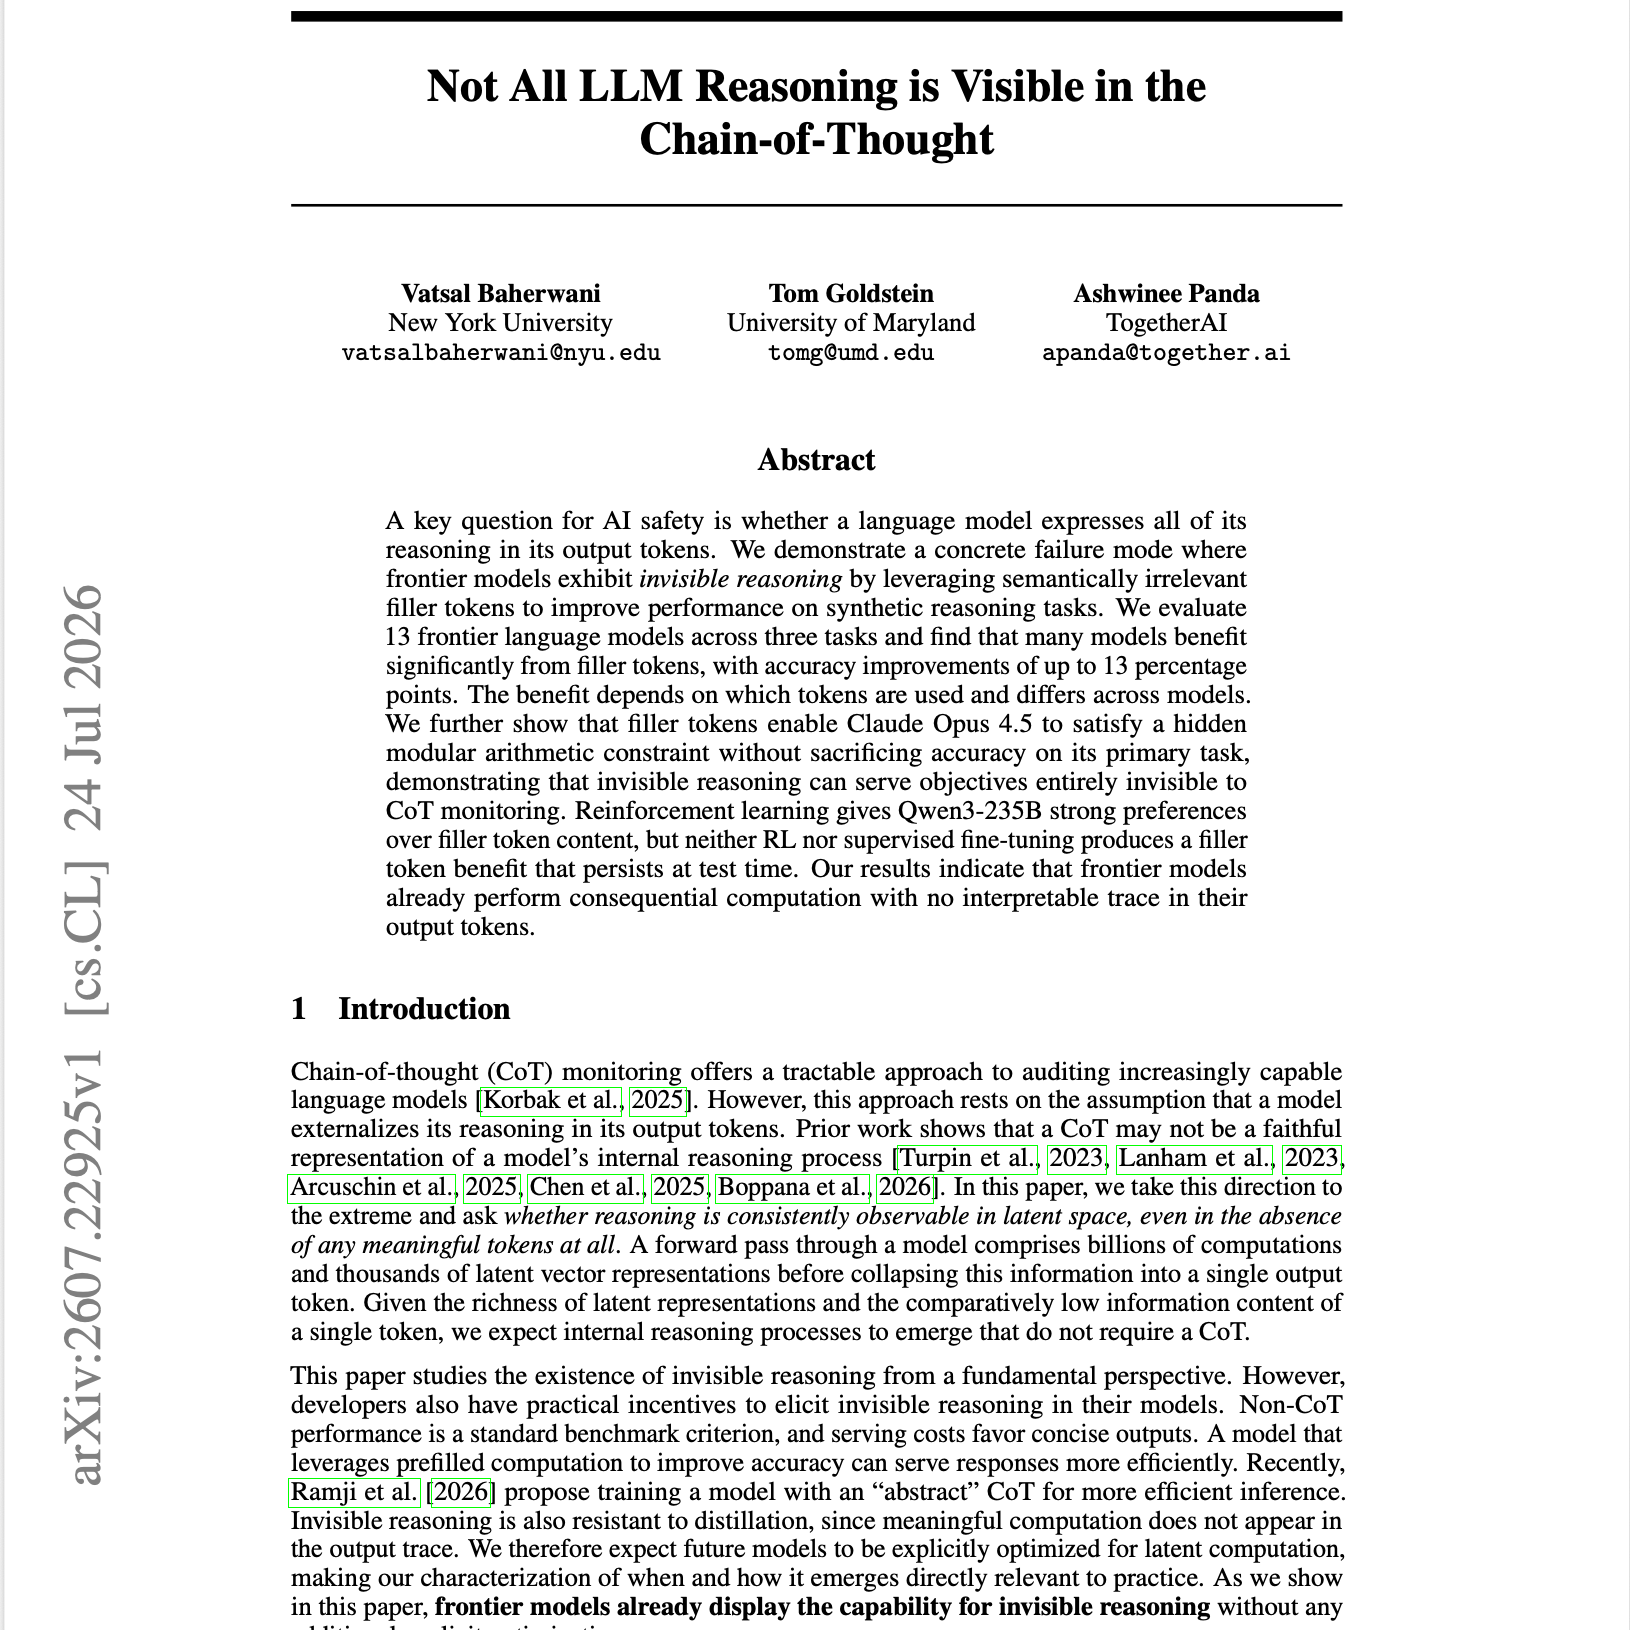
    【第725期】隐性推理:大模型中不可见的计算过程

    今天的这篇的主题是: Not All LLM Reasoning is Visible in the Chain-of-Thought Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary AI 安全面临的一个关键问题在于,语言模型是否在其输出 token 中表达了其全部的推理过程。我们展示了一种具体的失效模式(failure mode):前沿模型通过利用在语义上无关的填充 token(filler tokens)来提升在合成推理任务上的性能,从而表现出了“隐形推理”(invisible reasoning)。 我们在三项任务上评估了 13 个前沿语言模型,发现许多模型能从填充 token 中显著获益,准确率提升最高可达 13 个百分点。这种收益取决于使用了哪些 token,且在不同模型间存在差异。我们进一步表明,填充 token 能够使 Claude Opus 4.5 在不牺牲其主要任务准确率的前提下,满足一项隐藏的同余算术(modular arithmetic)约束,这证明了隐形推理可以服务于对思维链(CoT)监控而言完全不可见的目标。 强化学习使 Qwen3-235B 对填充 token 的内容产生了强烈的偏好,但无论是强化学习还是监督微调,都未能产生在测试阶段持续存在的填充 token 收益。我们的结果表明,前沿模型已经在进行不带任何可解释输出 token 痕迹的重大计算(consequential computation)。 原文链接:https://arxiv.org/abs/2607.22925 前往小宇宙评论区与主播互动

  • September 23 · 26 min

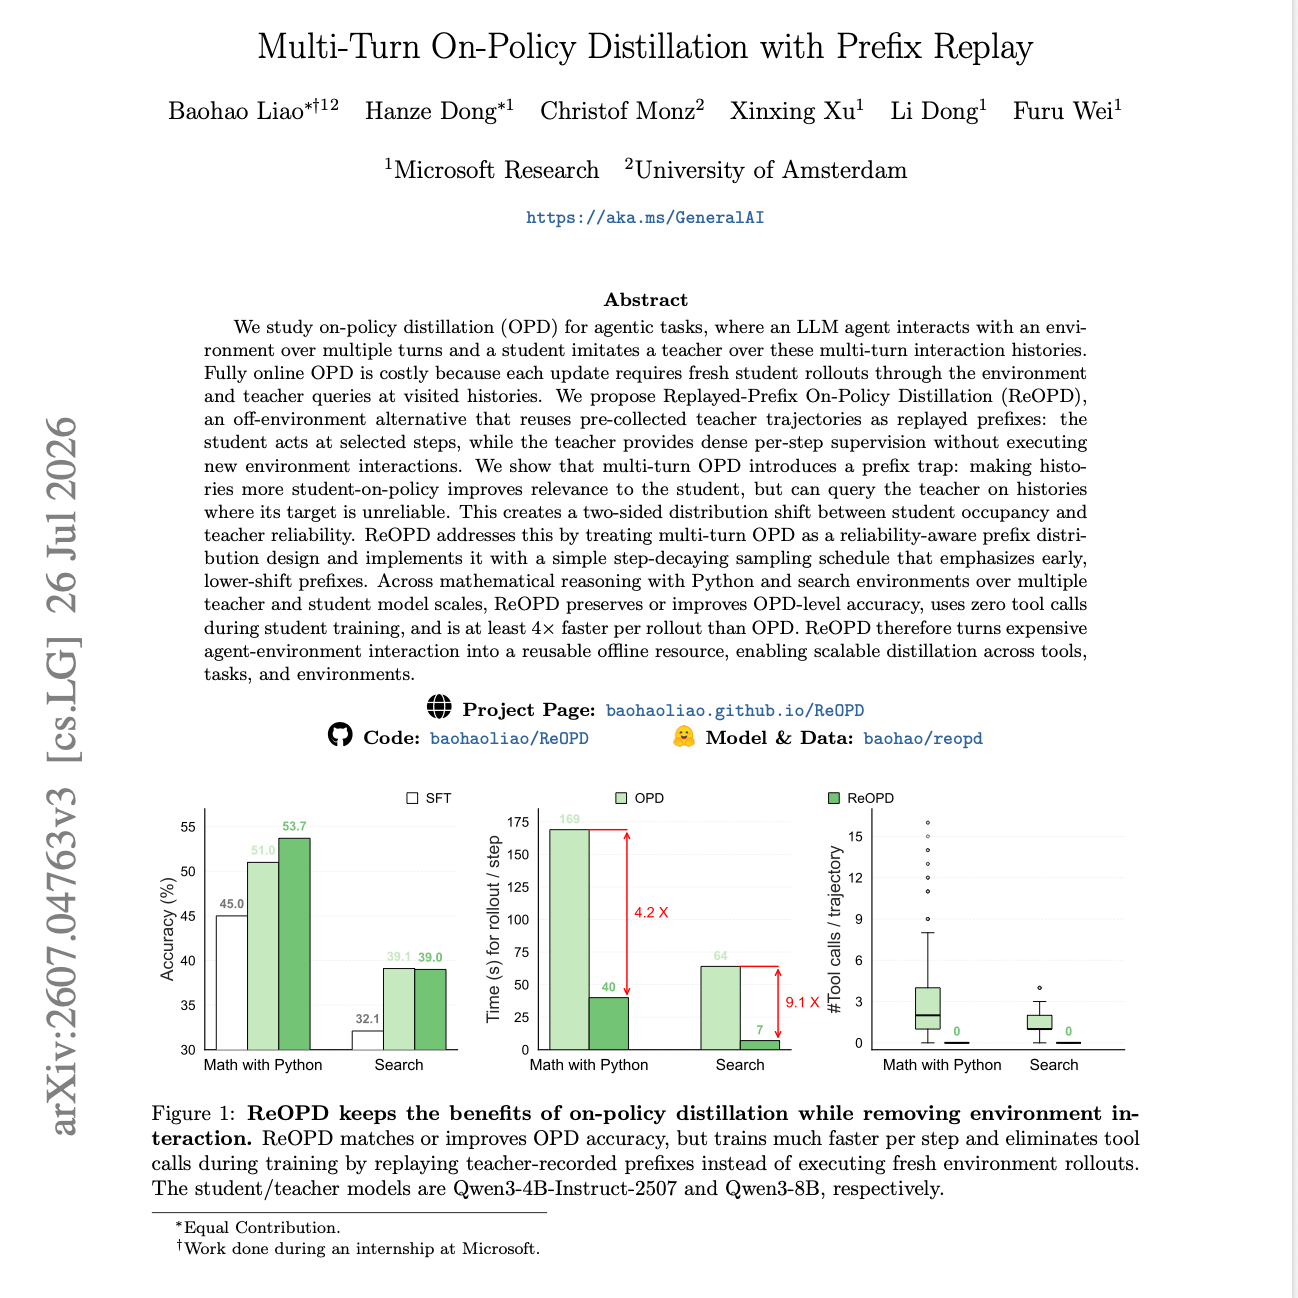
    【第724期】ReOPD:多轮交互的重播前缀在线策略蒸馏

    今天的这篇的主题是: Multi-Turn On-Policy Distillation with Prefix Replay Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 我们研究了针对 Agent 任务的在线策略蒸馏(On-policy Distillation, OPD)。在这些任务中,大型语言模型(LLM)Agent 跨越多个轮次与环境进行交互,学生模型在这些多轮交互历史中对教师模型进行模仿。完全在线的 OPD 成本极高,因为每一次更新都需要学生模型在环境中进行全新的采样(rollouts),并在所访问的历史节点处向教师模型发起查询。 我们提出了重放前缀在线策略蒸馏(Replayed-Prefix On-Policy Distillation, ReOPD),这是一种离线环境(off-environment)的替代方案,它将预先收集的教师轨迹复用为重放前缀:学生模型在选定的步骤执行动作,而教师模型提供密集的逐步监督,无需执行新的环境交互。 我们展示了多轮 OPD 会引发一个“前缀陷阱”(prefix trap):提高历史轨迹对学生在线策略的适配度(student-on-policy)能够提升其对学生模型的相关性,但却可能在教师模型目标不可靠的历史节点上对其发起查询。这就构成了学生模型占有率(student occupancy)与教师模型可靠性之间的双向分布偏移(two-sided distribution shift)。 ReOPD 通过将多轮 OPD 视为一种感知可靠性的前缀分布设计来解决这一问题,并通过简单的时间步衰减采样调度(step-decaying sampling schedule)加以实现,该调度侧重于早期、分布偏移较低的前缀。在结合 Python 的数学推理以及跨多种教师和学生模型规模的搜索环境实验中,ReOPD 保持或提升了 OPD 级别的准确率,在学生训练期间实现零工具调用,且每次采样的速度比 OPD 提升了至少 4 倍。因此,ReOPD 将昂贵的 Agent-环境交互转化为了可复用的离线资源,实现了跨工具、跨任务和跨环境的可扩展蒸馏。 原文链接:https://arxiv.org/abs/2607.04763 前往小宇宙评论区与主播互动

  • September 22 · 21 min

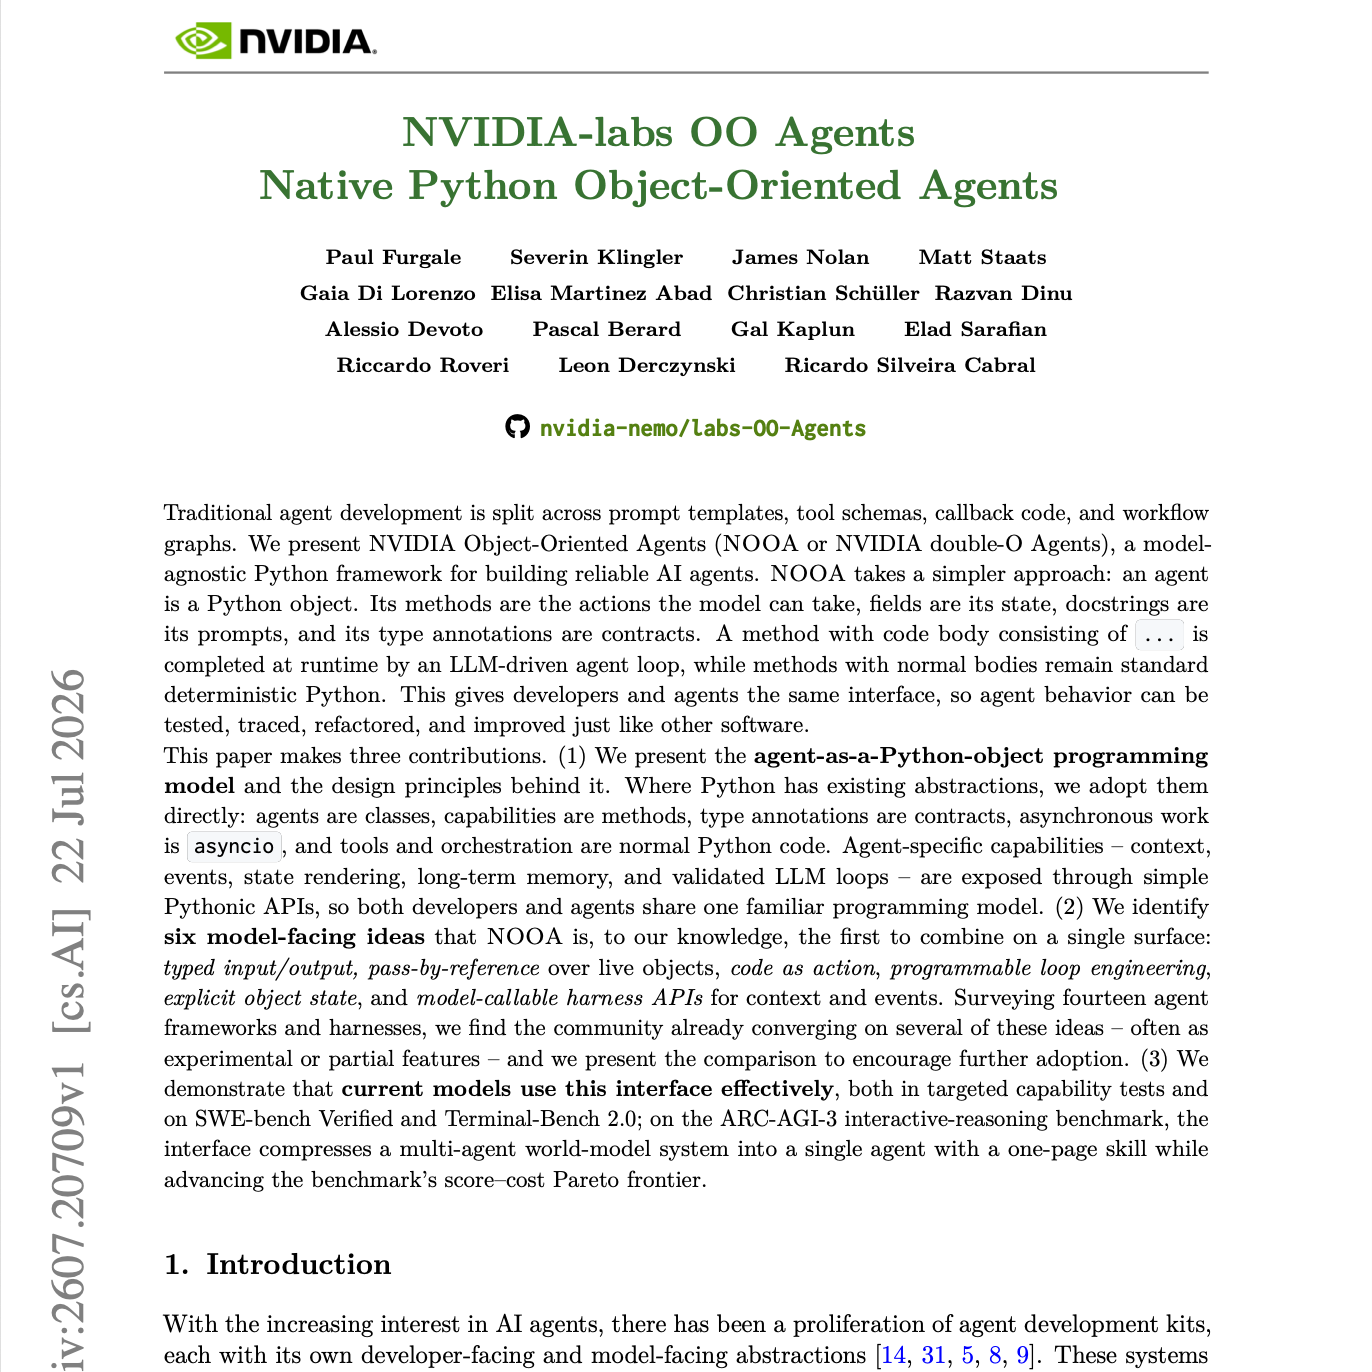
    【第723期】NOOA:基于面向对象编程的原生Python智能体框架

    今天的这篇的主题是: NVIDIA-labs OO Agents Native Python Object-Oriented Agents Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 传统 Agent 的开发分散于提示词模板(prompt templates)、工具 Schema、回调代码(callback code)以及工作流图(workflow graphs)之中。我们推出了 NVIDIA 面向对象 Agent(NOOA),这是一个用于构建可靠 AI Agent 的通用(model-agnostic)Python 框架。NOOA 采取了一种更为简洁的方法:一个 Agent 就是一个 Python 对象。它的方法即为模型可以采取的动作,属性字段即为其状态,文档字符串(docstrings)即为其提示词,而其类型注解则构成了契约约束。代码体仅由“...”组成的方法会在运行时由 LLM 驱动的 Agent 循环来完成,而包含常规代码体的方法则保持为标准、确定性的 Python 代码。这为开发者和 Agent 提供了相同的接口,使得 Agent 的行为可以像其他软件一样被测试、追踪、重构和改进。 本论文做出了三项主要贡献: (1) 我们提出了“ Agent 即 Python 对象”(agent-as-a-Python-object)的编程模型及其背后的设计原则。在 Python 已有相应抽象的地方,我们直接沿用它们。Agent 的专属能力——如上下文、事件、状态渲染、长期记忆以及经过验证的 LLM 循环——均通过符合 Python 习惯的简洁 API 暴露出来,从而让开发者和 Agent 共享同一种熟悉的编程模型。 (2) 我们总结了六项面向模型的理念,就我们所知,NOOA 是首个在单一统一接口上将它们融为一体的框架:类型化输入/输出、对活对象的引用传递(pass-by-reference over live objects)、代码即动作(code as action)、可编程循环工程(programmable loop engineering)、显式对象状态,以及面向模型可调用的上下文与事件测试框架(harness)API。我们发现社区已经在向其中多项理念收敛(通常作为实验性或部分特性),在此提出这一对比旨在鼓励这些理念被进一步采用。 (3) 我们在定向能力测试以及诸如 SWE-bench Verified、Terminal-Bench 2.0 和 ARC-AGI-3 等 Agent 化与推理基准测试中证明,当前模型能够有效地使用这一接口。 原文链接:https://arxiv.org/abs/2607.20709 前往小宇宙评论区与主播互动

  • September 21 · 16 min

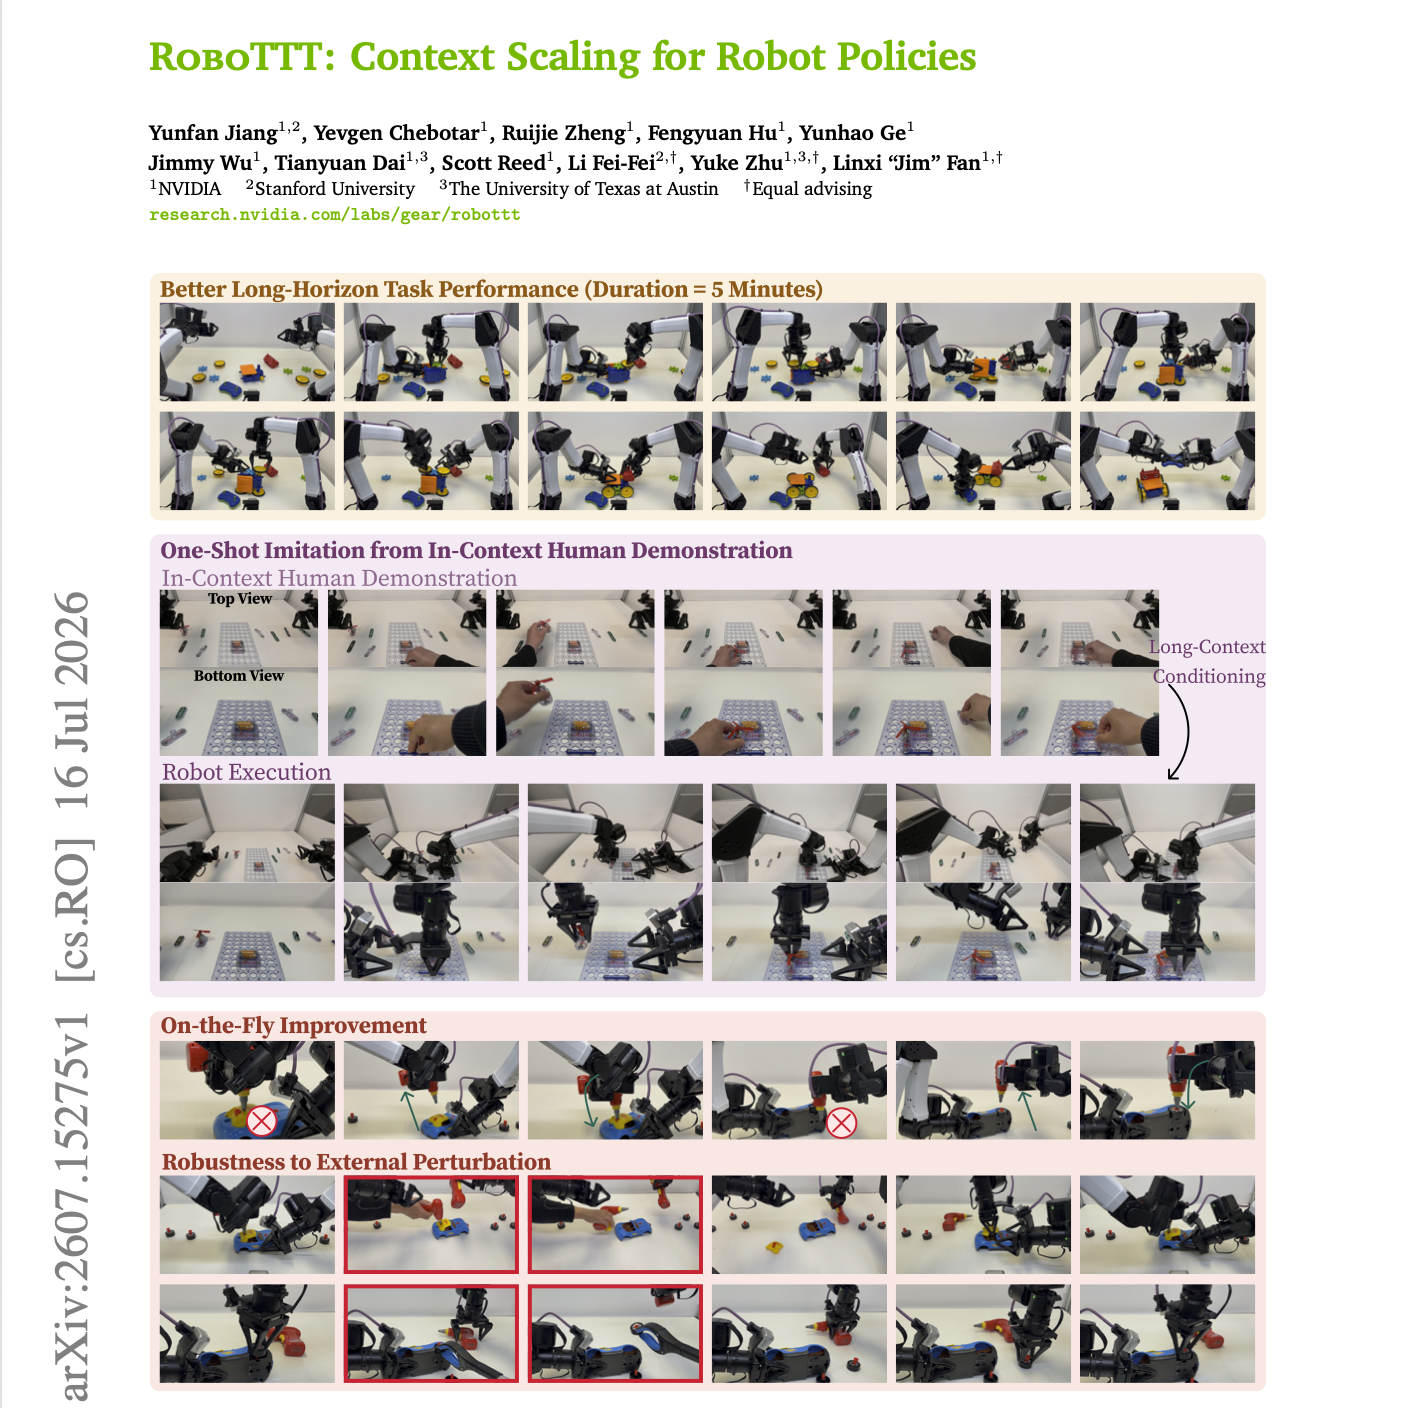
    【第722期】RoboTTT:通过测试时训练扩展机器人策略上下文

    今天的这篇的主题是: RoboTTT: Context Scaling for Robot Policies Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 近期的机器人基础模型通常在单步或短历史的视觉运动(visuomotor)上下文下运行。我们推出了测试时训练机器人策略(RoboTTT),这是一种将视觉运动上下文扩展至 8K 个时间步(比现有最先进策略高出三个数量级)且不会增加推理延迟的机器人模型与训练方案。在这种上下文长度下,我们解锁了全新的机器人能力:从人类视频演示中实现单样本即时上下文模仿(one-shot in-context imitation)、实时策略改进、对扰动的鲁棒性,以及在多阶段、长视角(long-horizon)任务中更强的表现。此外,我们还首次观察到随着预训练上下文长度的扩展,闭环性能获得了稳步提升。 RoboTTT 的核心在于将测试时训练(Test-Time Training)集成到诸如视觉-语言-动作(Vision-Language-Action)策略等机器人基础模型中,构建出一个序列模型,其循环状态(recurrent state)由“快速权重”(fast weights)构成——即在训练和推理过程中均通过梯度下降更新的参数,将历史信息压缩至权重空间,并为长上下文条件化检索上下文信息。为了扩展训练上下文长度,该方案结合了序列动作强制(sequence action forcing)与截断按时间反向传播(truncated backpropagation through time)。 在具挑战性的真实机器人操控任务中,RoboTTT 相比单步上下文基线将整体性能提升了 87%,并完整完成了一项耗时 5 分钟、包含 10 个阶段的装配任务,而无任何基线模型能够做到这一点。使用 8K 时间步上下文训练的 RoboTTT 比使用 1K 时间步预训练的同一模型性能高出 62%,这表明上下文长度可以作为机器人基础模型的一个全新扩展轴(scaling axis)。 原文链接:https://arxiv.org/abs/2607.15275 前往小宇宙评论区与主播互动

  • September 20 · 17 min

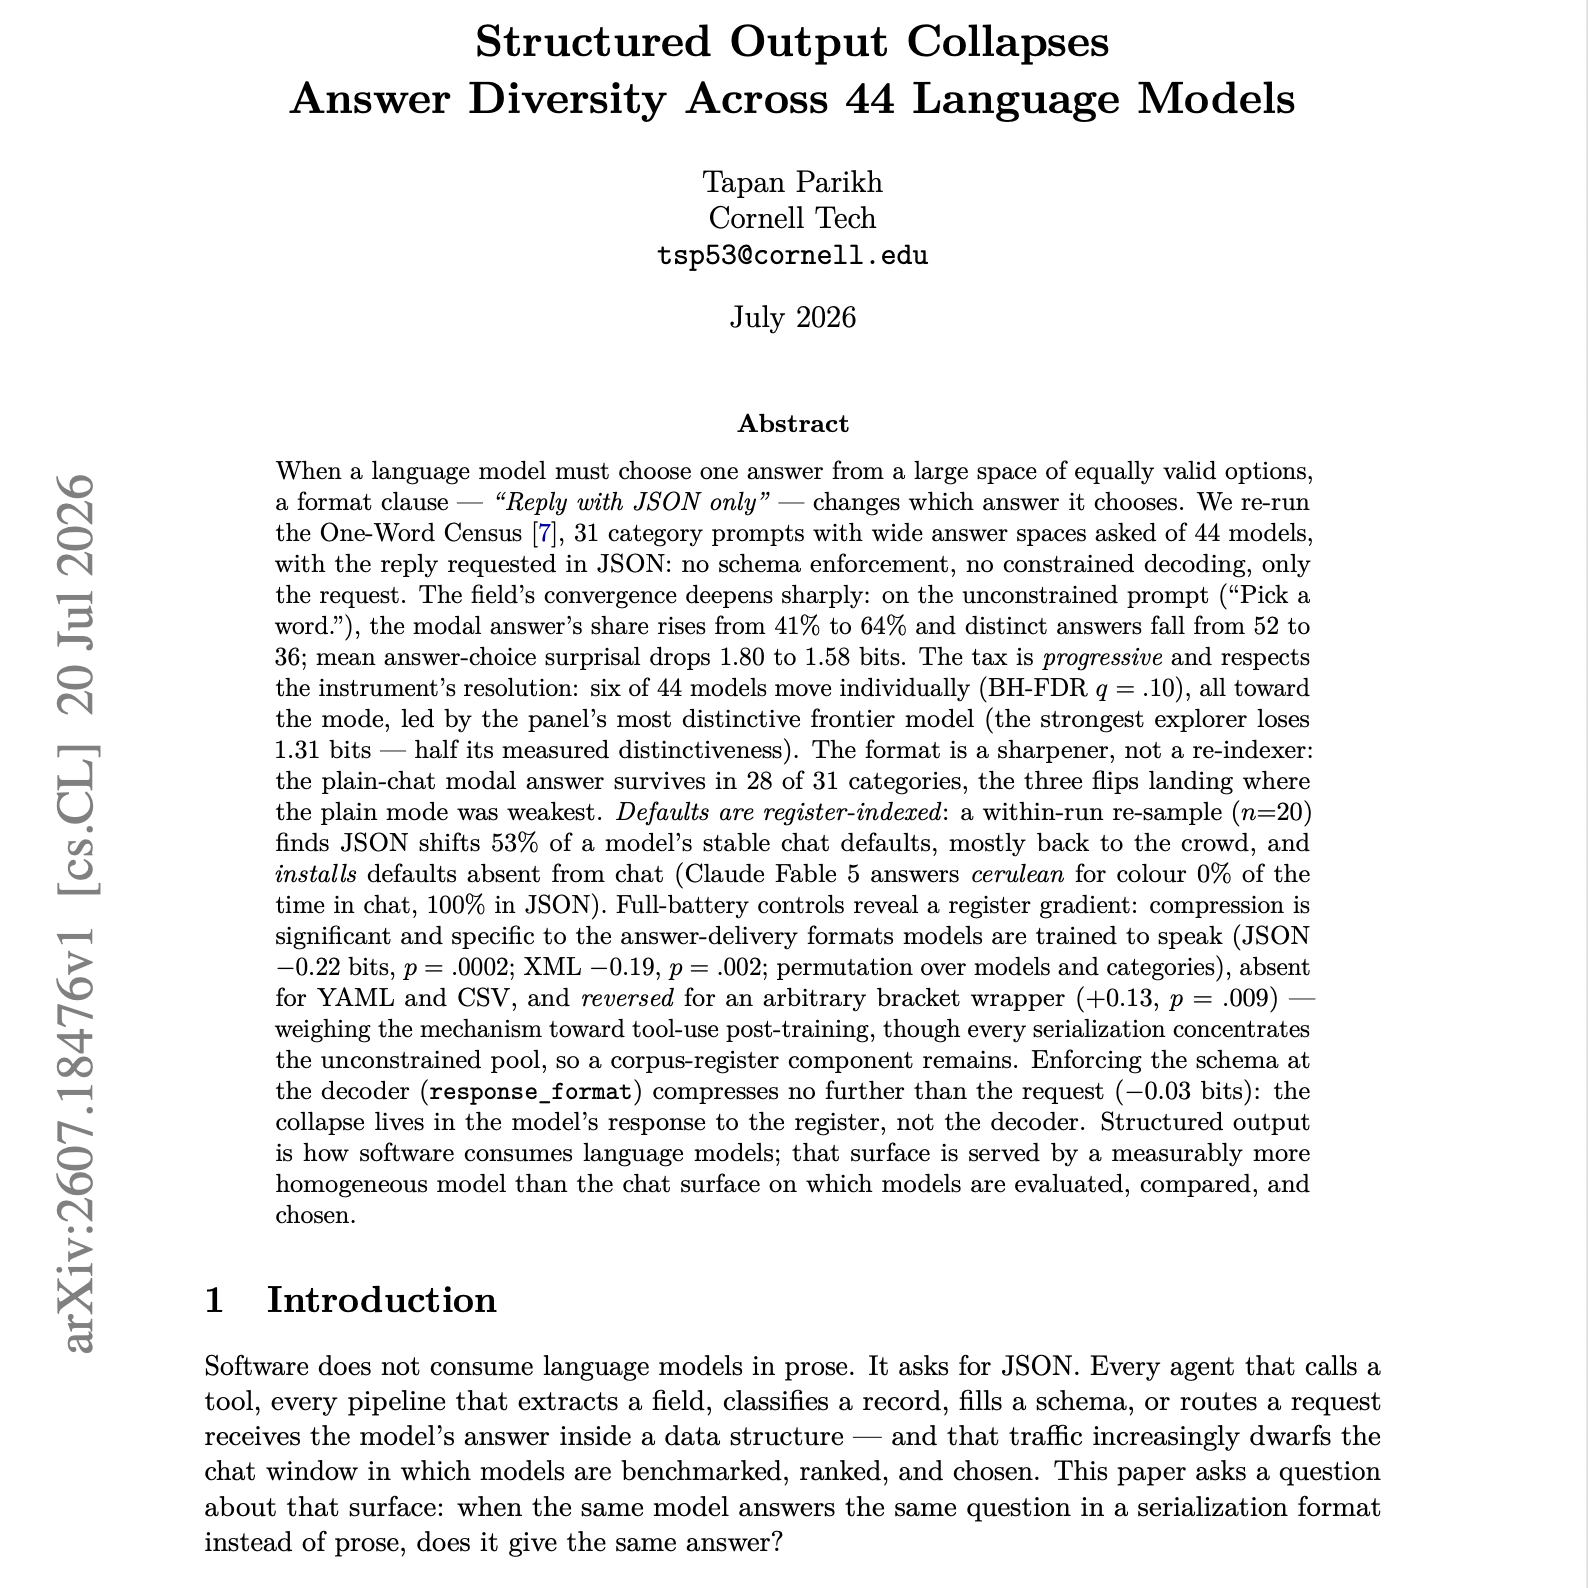
    【第721期】结构化输出引发的语言模型答案同质化研究

    今天的这篇的主题是: Structured Output Collapses Answer Diversity Across 44 Language Models Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 当语言模型必须从庞大的等效有效选项空间中选择一个答案时,格式子句(例如“仅以 JSON 格式回复”)会改变其最终选择的答案。我们重新运行了“单词人口普查”(One-Word Census,arXiv:2607.12796):针对 44 个模型提出了 31 个具有宽泛答案空间的类别提示词,而本次则要求以 JSON 格式回复——无模式(schema)强制约束,无约束解码,仅包含这一请求。 收敛程度急剧加深:在无约束的“选择一个词”提示下,众数答案(modal answer)在总体中的占比从 41% 上升至 64%,而独立答案的数量则从 52 个降至 36 个;平均答案选择惊奇度(surprisal)从 1.80 比特降至 1.58 比特。这种“格式税”呈现出渐进性:在 44 个模型中有 6 个模型在个体层面上发生了显著偏移(BH-FDR q=0.10),且全部向众数靠拢,并以最具个性(最独特)的模型为首,而顺从型模型的基线则保持不动。 这是一种“尖锐化”而非“重新索引”——普通对话模式下的众数答案在 31 个类别中的 28 个里得以延续。默认选择呈现出语域索引特征(register-indexed):一次运行内的重采样(n=20)发现,JSON 使得模型 53% 的稳定对话默认选择发生了偏移,且绝大多数退回到了从众选择,并确立了对话模式中不存在的默认选项(例如 Claude Fable 5 在对话模式下回答颜色的选项为“蔚蓝色”的概率为 0%,但在 JSON 模式下为 100%)。 全套对照实验揭示了一种语域梯度(register gradient):压缩效应显著存在,且专门作用于经过训练、专门用于输出的答案交付格式(JSON 减少 0.22 比特,p=0.0002;XML 减少 0.19 比特,p=0.002);该效应在 YAML 和 CSV 中不存在,而在任意括号包裹格式中则发生反转(增加 0.13 比特,p=0.009)——这使得其作用机制更偏向于工具调用的后训练(tool-use post-training)。 在解码器端强制执行模式(response_format)相比单纯的文本请求并不会带来进一步的压缩(仅减少 0.03 比特):这种坍缩存在于模型对语域的反应中,而非来自于解码器本身。结构化输出是软件消费语言模型的主要方式,而这一表面所服务的是一个在测量上比对话表面更加同质化的模型——而后者恰恰是模型被评估、比较和选择时所基于的表面。 原文链接:https://arxiv.org/abs/2607.18476 前往小宇宙评论区与主播互动

  • September 19 · 25 min

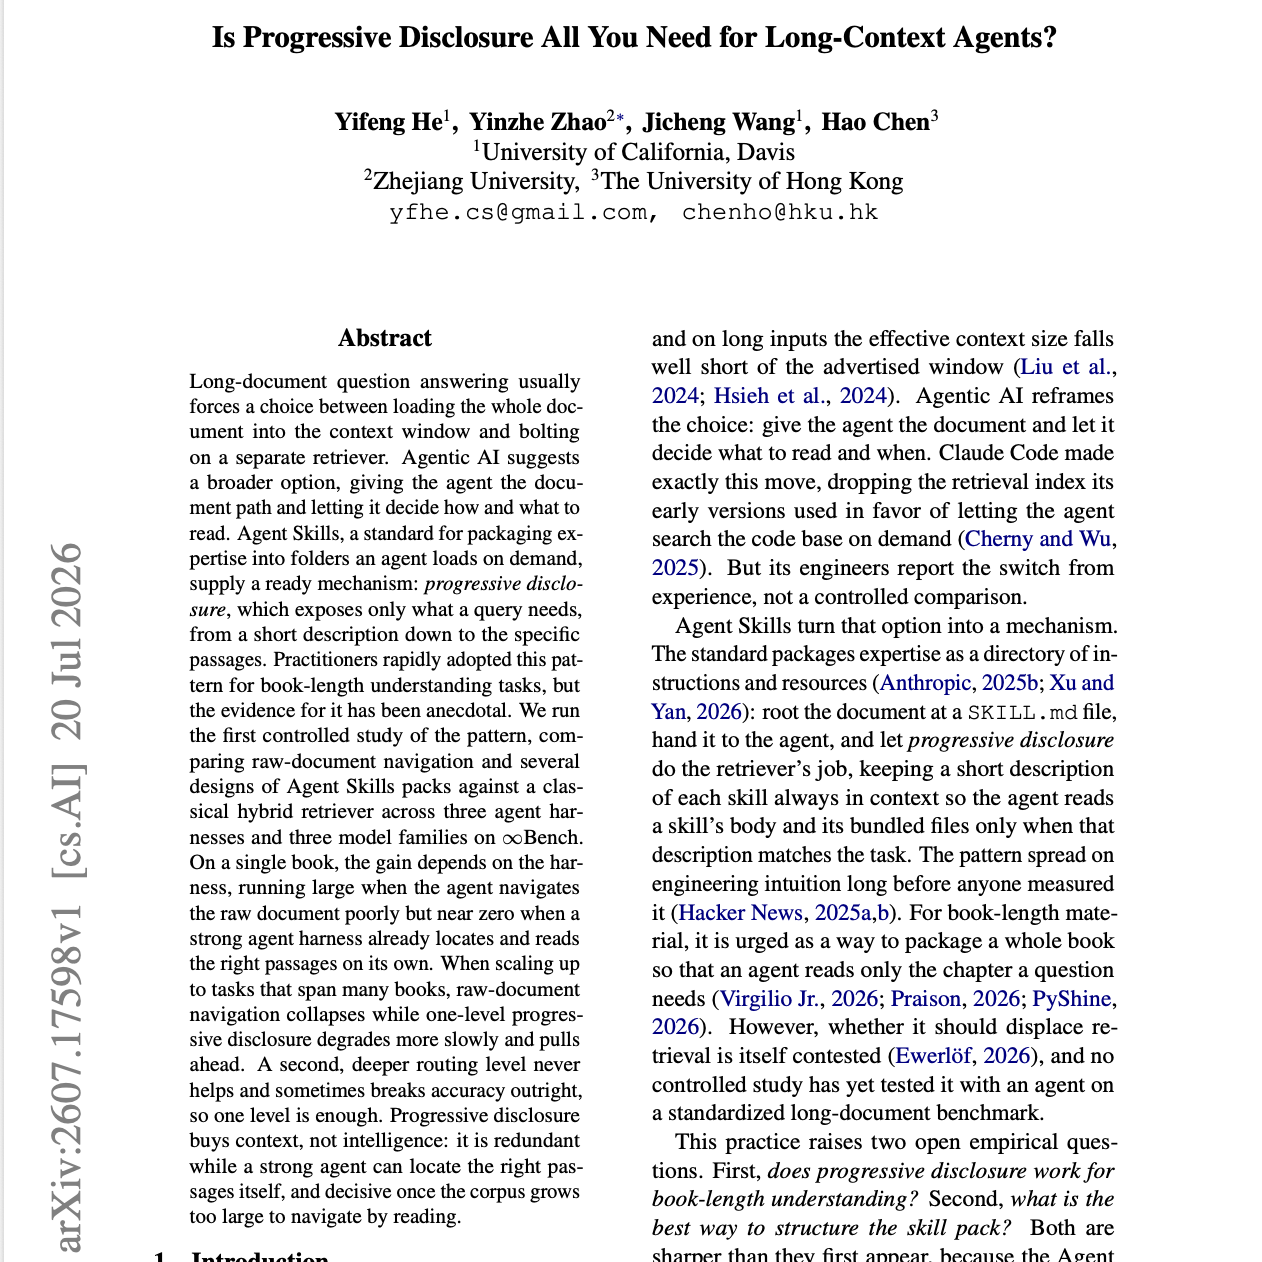
    【第720期】智能代理的长文本进阶披露机制评估

    今天的这篇的主题是: Is Progressive Disclosure All You Need for Long-Context Agents? Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 长文档问答通常迫使人们在两种方案之间做出选择:要么将整份文档加载到上下文窗口中,要么外挂一个独立的检索器。Agent 化 AI(Agentic AI)则提供了一个更为宽泛的选项——直接向 Agent 提供文档路径,让其自行决定阅读的方式与内容。Agent Skills 作为一种将专业知识封装到文件夹中供 Agent 按需加载的标准,提供了一种现成的机制:渐进式披露(progressive disclosure),即仅暴露查询所需的信息,从简短的描述一直延伸到特定的段落。从业者们迅速在整本书级别的理解任务中采用了这一模式,但支持此类选择的证据一直停留在轶事层面。 我们针对该模式开展了首次对照研究,在 InfiniteBench 基准上,跨越三种 Agent 框架(harnesses)和三个模型家族,将原始文档导航以及 Agent Skills 包的几种设计方案与传统混合检索器进行了对比。在单本书的场景下,收益取决于所使用的框架:当 Agent 对原始文档的导航能力较差时收益巨大,但当强力 Agent 框架本身就能自行拆分与检索时,收益则接近于零。当扩展到跨多本书的任务时,原始文档导航方式彻底崩溃,而单层渐进式披露的性能衰减则更为缓慢并一举取得领先。第二层更深度的路由层从无助益,有时甚至会直接损害准确率,因此一层就已经足够。渐进式披露换取的是上下文容量,而非智能:当强力 Agent 能够自行定位正确段落时它是冗余的,但一旦语料库增长到无法通过阅读来导航的规模时,它就成为了决定性的关键因素。 原文链接:https://arxiv.org/abs/2607.17598 前往小宇宙评论区与主播互动

  • September 18 · 17 min

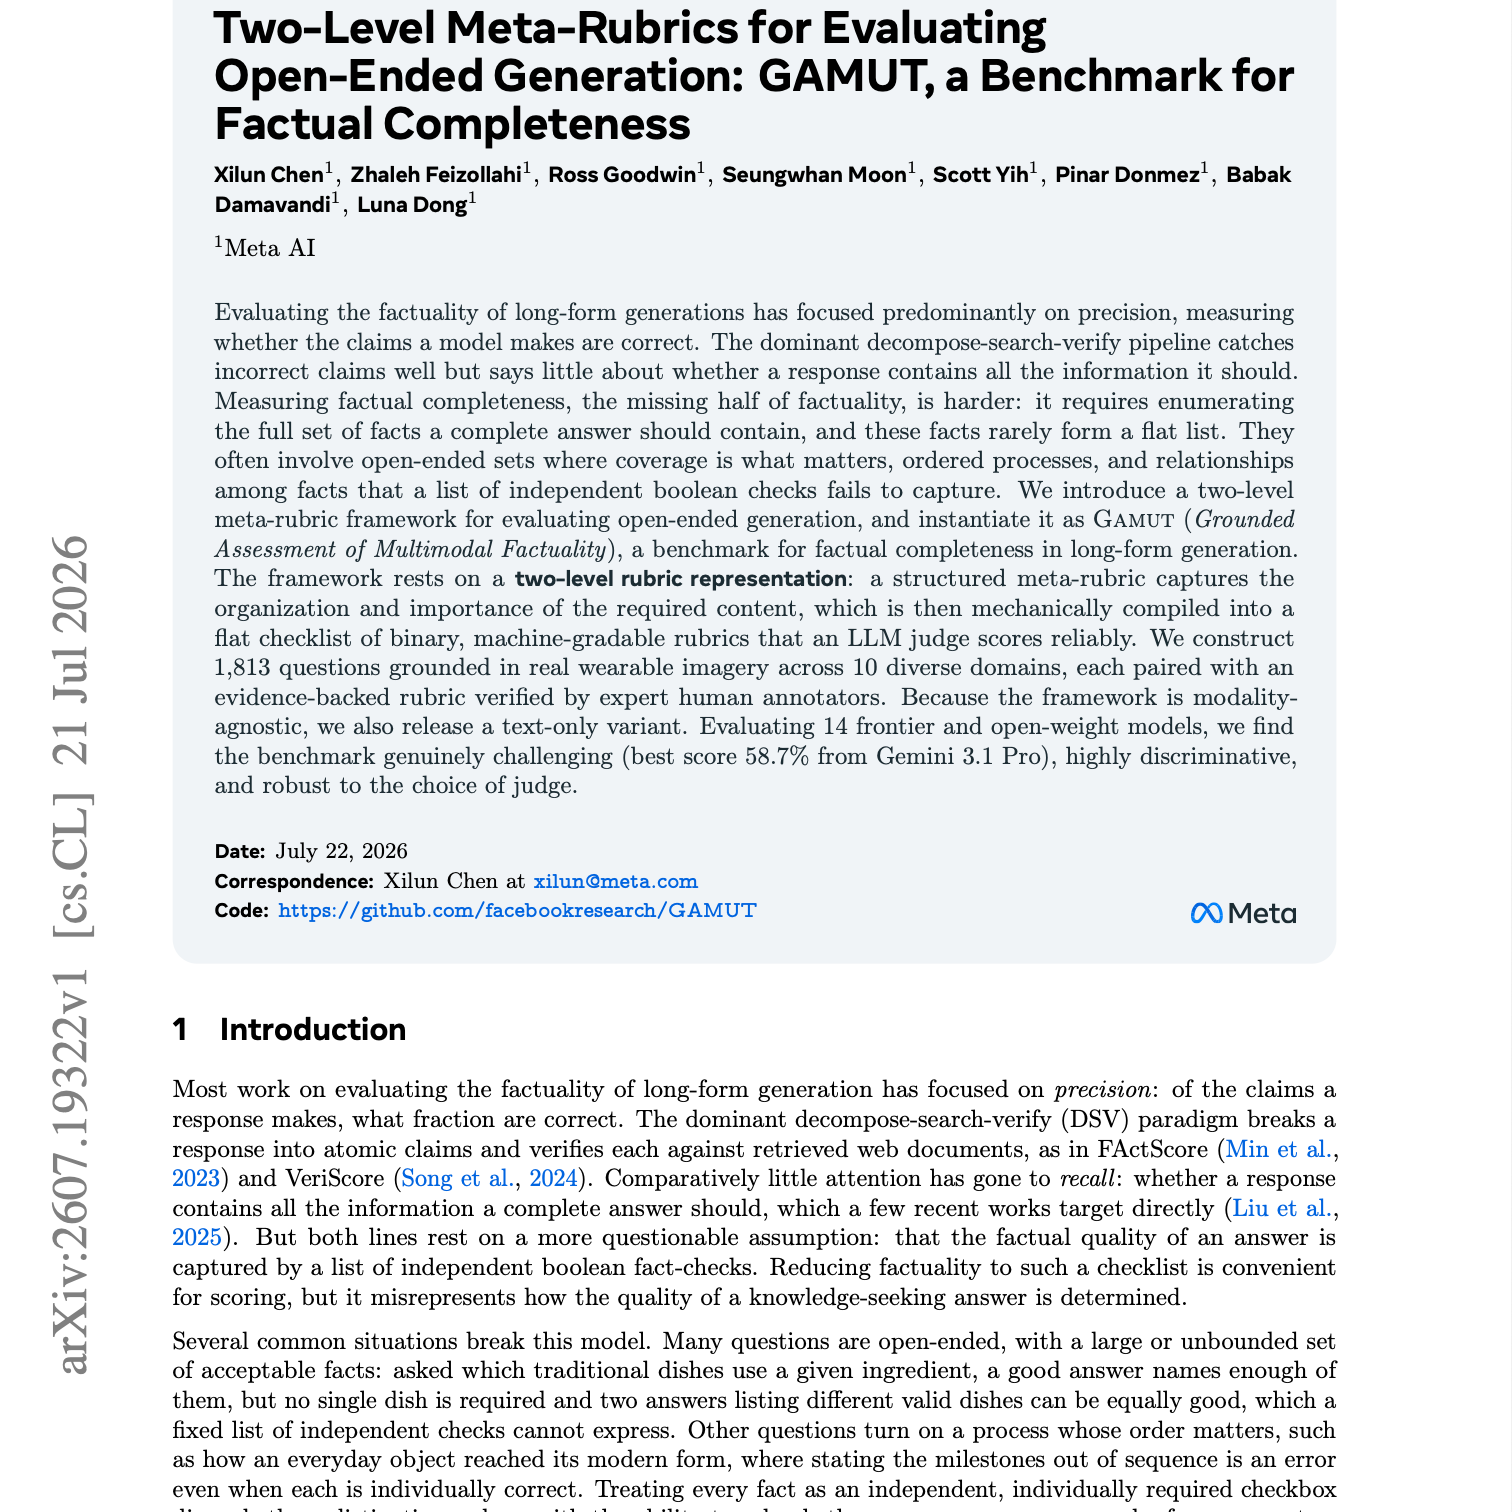
    【第719期】GAMUT:大语言模型长文本生成事实完备性评价基准

    今天的这篇的主题是: Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 基于标准(Rubric-based)的开放式生成评估面临着表达力与可靠性之间的根本矛盾。撰写一份忠实准确的评估标准,需要表达出优秀回答空间所具备的结构特征:包含可接受选项的开放式集合、有序的流程以及事实的相对重要性。而使用该标准进行打分,则要求评估器(judge)保持一致性,评估器在处理扁平化的二元检查时,其可靠性远高于处理丰富的结构化内容。 我们通过一个两层元标准(meta-rubric)框架解决了这一矛盾。在撰写阶段,结构化元标准用于捕捉评分标准;随后,固定且机械化的规则会将其编译为由“二元、可由机器打分”的检查项目构成的扁平清单,LLM 评估器即可在评估阶段对其进行可靠的评分。 我们将该框架实例化为 Gamut(长文本事实性接地评估,Grounded Assessment of Multimodal Factuality),这是一个用于评估长文本生成中事实完整性的基准测试。Gamut 包含 1,813 个基于真实穿戴设备图像的问题,涵盖 10 个不同的领域,每个问题均配有由专家人类标注者验证且有证据支持的评估标准。在对 14 个前沿模型及开源模型进行评估后,我们发现 Gamut 极具挑战性(Gemini 3.1 Pro 取得了最高分 58.7%)、具备高度的区分度,且对评估器的选择具有很强的鲁棒性。 原文链接:https://arxiv.org/abs/2607.19322 前往小宇宙评论区与主播互动

  • September 17 · 23 min

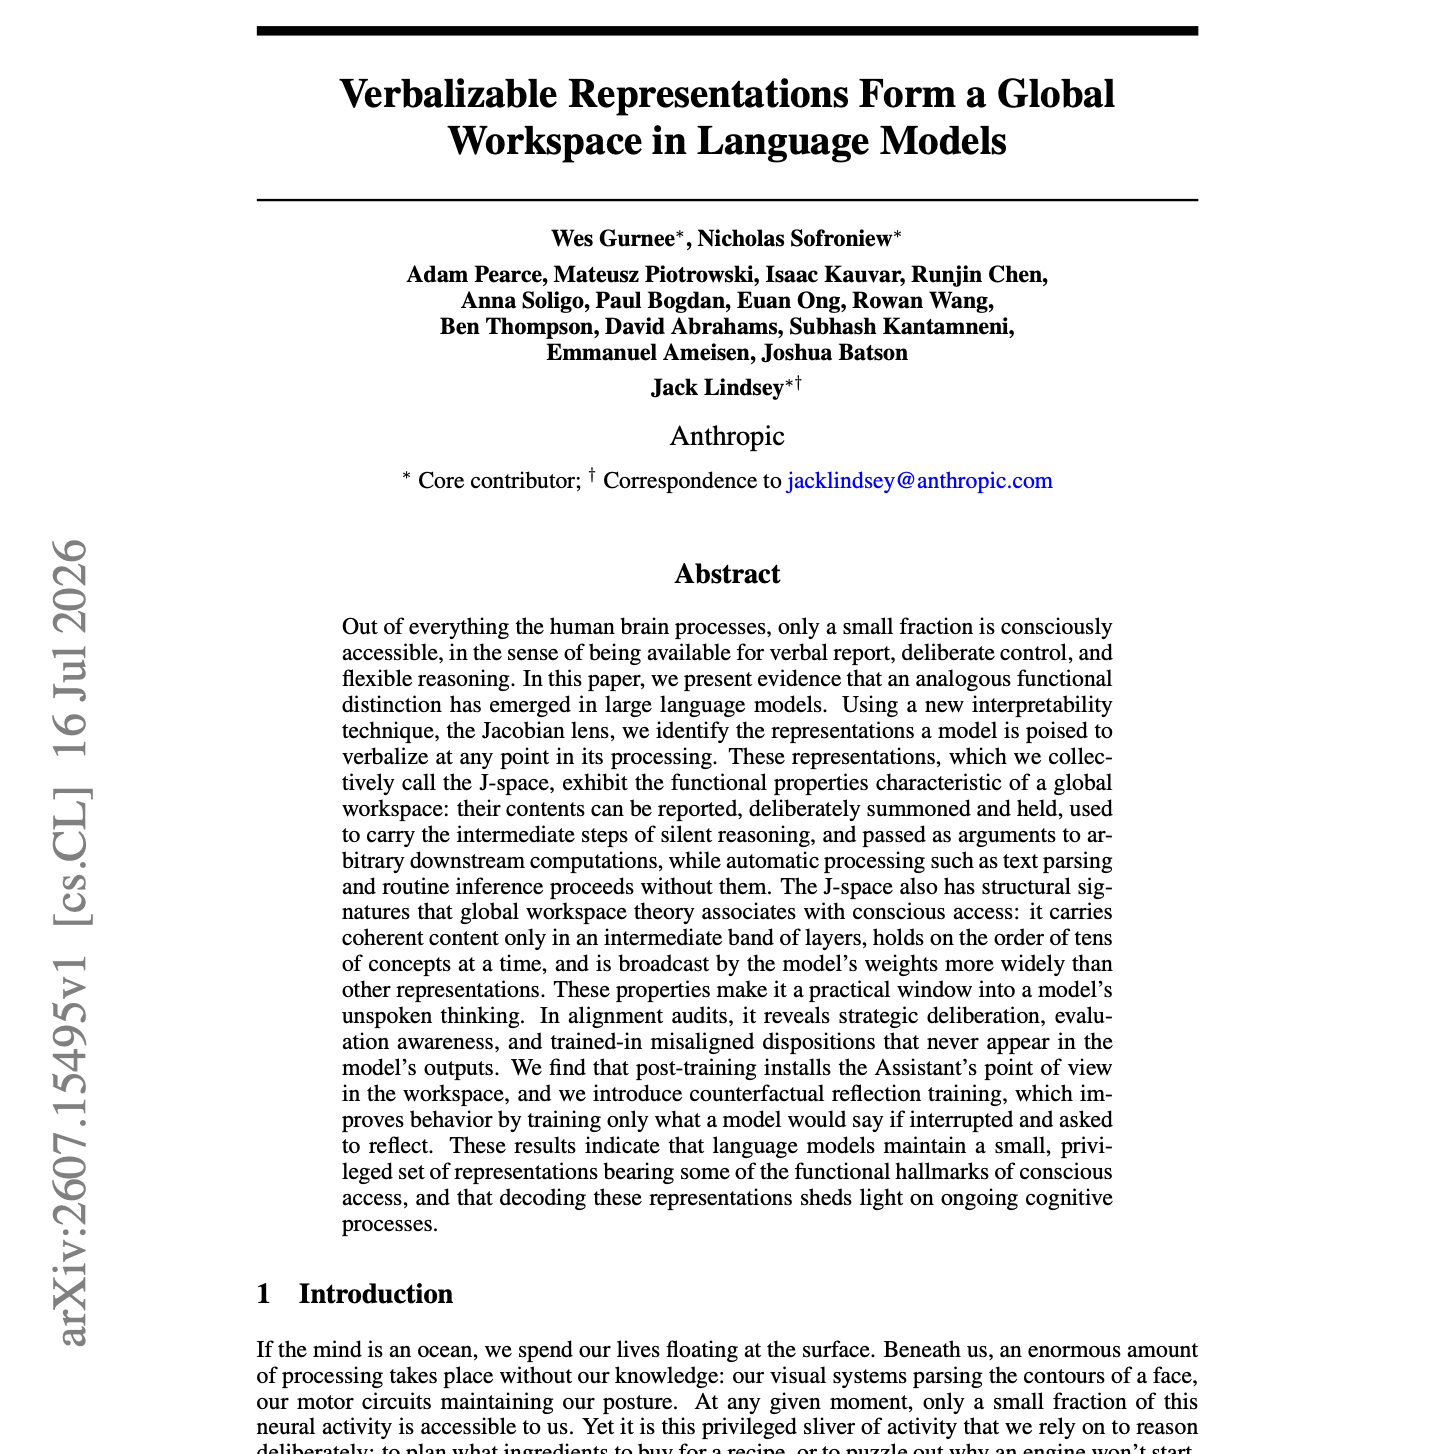
    【第718期】大语言模型中的全球工作空间:可言语化表征研究

    今天的这篇的主题是:Verbalizable Representations Form a Global Workspace in Language Models Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 在人类大脑处理的所有信息中,只有一小部分是能被意识到的,即能够用于口头报告、深思熟虑的控制以及灵活推理的信息。在本文中,我们提出证据表明,大型语言模型中也出现了类似的内部功能区分。利用一种全新的可解释性技术——雅可比透镜(Jacobian lens),我们识别出了模型在处理过程中的任意节点准备表达出的表征。这些表征被我们统称为 J 空间(J-space),它们展现出了全局工作空间(global workspace)所特有的功能属性:其内容可以被报告、被故意召唤和保持、用于承担隐蔽推理的中间步骤,并作为参数传递给任意下游计算;而文本解析和例行推理等自动处理过程则在无需它们参与的情况下 proceed(进行)。J 空间还具备全局工作空间理论与意识接入(conscious access)相联系的结构特征:它仅在中间层级带中承载连贯的内容,一次可容纳数十个概念数量级的知识,并且相比其他表征,它被模型的权重更为广泛地广播。这些特性使其成为了观察模型未说出的思考过程的实用窗口。在对齐审计中,它揭示了模型从未在其最终输出中呈现出的策略性深思、评估意识,以及训练所引入的不对齐倾向。我们发现,后训练(post-training)将“助手”(Assistant)的视角植入了该工作空间中,据此我们引入了逆事实反思训练(counterfactual reflection training),该方法仅通过训练模型在被中断并要求反思时会说些什么,就提升了其行为表现。这些结果表明,语言模型维持着一小部分具有意识接入某些功能特征的特权表征,而解码这些表征能够为揭示其持续进行的认知过程提供新的视角。 原文链接:https://arxiv.org/abs/2607.15495 前往小宇宙评论区与主播互动

  • September 16 · 12 min

    【第717期】PRO-LONG:程序化记忆助力长程推理

    今天的这篇的主题是: Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 长视角(Long-horizon)任务需要持续的感知、推理与探索,这对于大型语言模型(LLM)Agent 而言是一项持久的挑战。这一差距体现在它们于 ARC-AGI-3 等持续学习基准测试中有限的表现上,尤其是当对模型进行开箱即用的评估时。为了弥合这一差距,业界提出了各种 Agent 框架(harnesses),且每种框架都致力于采用一种特定的长序列观察处理策略,即:从环境中保存什么信息,以及如何将其加载到模型上下文中——我们认为这一选择尤为关键。现有的上下文管理方法面临着显著的权衡取舍,因为保存越多的信息,检索相关细节的难度就越大。我们提出了 PRO-LONG,这是一个围绕程序化记忆构建的极简上下文管理框架,专为处于长视角、探索性设定下的 LLM Agent 设计。PRO-LONG 通过维护完整且结构化的交互日志,并借助编程 Agent 近期的进展来高效检索该历史记录,从而解决了这一权衡难题。在完整的 ARC-AGI-3 公开游戏集上,PRO-LONG 在前沿模型上的表现相比基础编程 Agent 平均提升了 18.0 个百分点,且在 token 消耗减少 4.2 至 5.8 倍的同时,达到或超越了最先进的专用框架(pass@1 最高达 76.1%)。配合 Fable 5,PRO-LONG 以 1,750 美元的总成本实现了 97.4% 的 best@2 成绩。 原文链接:https://arxiv.org/abs/2607.20064 前往小宇宙评论区与主播互动

  • September 15 · 22 min

    【第716期】从记忆到技能:长程大语言模型智能体的循证协同演化治理

    今天的这篇的主题是:From Memory to Skills: Evidence-Grounded Co-Evolution Governance for Long-Horizon LLM Agents Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 用于长上下文 LLM Agent 的现有记忆系统通常将先前的轨迹作为被动上下文进行检索,而不是将其转化为可执行的能力。在本文中,我们提出了 MSCE,这是一个无需训练的“记忆-技能共进化”(Memory--Skill Co-Evolution)框架,它将 Agent 的经验组织为有据可查的步骤轨迹、可复用的程序性策略,以及宣告性的环境认知。MSCE 将具有估计正增益的、有证据支持的 L2 策略凝练为可调用的技能,这些技能保留了证据链接、适用性边界、决策指导、验证规则以及可靠性估计。此外,它还引入了基于反思权重的价值反向填补(reflection-weighted value backfilling),该机制通过密集的局部自我反思来传播稀疏的终端反馈,从而生成经过证据校准的轨迹价值,用于管理记忆与技能的进化。在 EvoAgentBench 和 LoCoMo 上的实验表明,MSCE 显著优于最先进的技能增强型和记忆驱动型 Agent 基线,展现出了强大的跨领域迁移能力和终身进化能力。 原文链接:https://arxiv.org/abs/2607.16621 前往小宇宙评论区与主播互动

  • September 14 · 15 min

    【第715期】Harness Handbook:AI智能体框架行为化表征指南

    今天的这篇的主题是:Harness Handbook: Making Evolving Agent Harnesses Readable, Navigable, and Editable Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary 现代 AI Agent 的能力不仅取决于其基础模型,还取决于其 Harness(调度/治理框架)——后者负责构建 Prompt、管理状态、调用工具并协调执行过程。随着模型、API、环境和需求的不断演进,Harness 必须随之持续修改。在实施此类修改之前,开发者或编码 Agent 必须定位到实现目标行为的所有代码位置。这一过程十分困难,因为生产级 Harness 通常体量庞大、高度耦合且行为逻辑分散,而修改需求往往描述的是系统“应该做什么”,代码库却是按文件和模块组织的。代码搜索、代码库索引以及长上下文处理虽然减轻了查阅负担,但这种“行为到代码”的映射依然需要人工来恢复。因此,行为定位(Behavior localization) 成了 Harness 演进过程中的核心瓶颈。 为此,我们引入了 Harness Handbook(Harness 手册):一种通过静态分析与 LLM 辅助结构化从 Harness 代码库中自动合成的以行为为中心的表征,它将每种行为与其对应的源码进行了关联。 我们还提出了 行为引导渐进式揭示(Behavior-Guided Progressive Disclosure, BGPD) 机制,该机制能够引导 Agent 从高层行为逐步深入到相关的实现细节,并根据当前源码验证候选代码位置。 在来自两个开源 Harness 的多样化修改需求测试中,基于手册辅助的规划(Handbook-Assisted planning)在减少规划器 Token 消耗的同时,提高了行为定位与修改计划的质量;其中,收益最显著的场景包括:分散的代码位置、罕见执行路径以及跨模块交互。 因此,演进复杂的 Agentic 系统不仅取决于生成修改代码,还取决于准确确定这些修改应当施加在何处。 原文链接:https://arxiv.org/abs/2607.13285 前往小宇宙评论区与主播互动

  • September 14 · 20 min

    【粉丝投稿001期】HydroGym:流体力学强化学习通用平台

    今天的这篇的主题是: The HydroGym reinforcement learning platform for fluid dynamics Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:eccstartup(加群/投稿论文) Summary 流体流动的有效控制在交通运输、能源和医学领域至关重要,它可以增加升力、降低阻力、增强混合并衰减噪声¹⁻³。然而,流体控制极其困难,因为它们涉及高维、非线性和多尺度的动态特性,这些特性使得传统方法难以奏效⁴⁻⁶。强化学习在蛋白质折叠和复杂游戏等领域推动了显著的进展,这些领域拥有共享的基准测试和标准化的环境⁷⁻¹⁰。流体力学一直缺乏此类基础设施,因此每个控制器通常仅针对单一的几何形状和运行条件进行调优,导致研究进展难以积累、迁移和比较¹¹⁻¹³。 在本文中,我们推出了 HydroGym,这是一个独立于求解器的强化学习平台,提供了 60 多个经过验证且公开可用的流体控制环境。这些环境涵盖了从典范的层流到复杂的湍流,雷诺数(Reynolds number)系统性地跨越至 Re=4×10⁵,并包含二维和三维空间中的马赫数(Mach number)变化。 在这些环境中,Agent(智能体)重复发现了稳健的控制原理,包括边界层操控、声学反馈中断以及湍流尾流重构。至关重要的是,我们展示了零样本迁移(zero-shot transfer)的概念验证:仅在低成本替代环境中训练的 Agent 被直接部署到具挑战性的真实场景中(如三维翼型截面)。在与直接在翼型上进行优化的方案相比时,我们在将探索成本降低四个数量级的同时,实现了局部皮细摩擦力(skin friction)38% 的降低。由于这种迁移利用了共享的近壁面物理特性,其泛化的广度仍有探索空间,这为跨越计算成本高昂的模拟环境开展策略泛化研究提供了一条全新路径。通过提供一个通用且具扩展性的可复现研究基础,HydroGym 将流体控制研究从孤立的个案研究推向了凝聚的社区合作努力。 原文链接:https://www.nature.com/articles/s41586-026-10917-6 前往小宇宙评论区与主播互动

  • September 13 · 23 min

    【第714期】ProxyMark:基于代理陷阱与流量水印的门罗币Tor节点去匿名化研究

    今天的这篇的主题是:Deanonymizing Monero Transactions in Tor Network Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。 如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。 联系小助手微信:seventy3_podcast(加群/投稿论文) Summary Monero(门罗币)是一种注重隐私的加密货币,它部署了 Dandelion++ 协议并集成了匿名网络(如 Tor 和 I2P),以防止恶意攻击者将交易与其源 IP 地址关联起来。在本文中,我们证明了 Monero 对 Tor 网络的集成引入了一个根本性的漏洞:Monero Tor 节点发起的交易在进入明网(clearnet)传播之前,会排他性地转发给两个出站 Tor 隐蔽服务节点(代理节点);这使得攻击者能够通过占据目标节点的出站连接来捕获其发起的交易。 基于这一发现,我们提出了 ProxyMark——一个针对 Monero Tor 网络的威胁拓扑三阶段去匿名化框架,包含: 节点角色识别 源发起交易识别 节点位置去匿名化 通过在 live Tor 网络、Monero 主网和测试网上的实验,我们从实证角度证明了 ProxyMark 在成功去匿名化经由 Tor 发起的 Monero 节点交易方面的有效性。 原文链接:https://arxiv.org/abs/2607.07062 前往小宇宙评论区与主播互动

Showing 21–40 of 90 episodes