Skip to content
Artwork for Andrej Karpathy的RSS订阅清单
TechnologyTech NewsEducation

Andrej Karpathy的RSS订阅清单

voieech.com

精选自 Andrej Karpathy 的 RSS 订阅清单,每日为你解读他在关注的技术博客文章,涵盖 AI、编程、安全等领域。OPML 来源:https://gist.githubusercontent.com/emschwartz/e6d2bf860ccc367fe37ff953ba6de66b/raw/hn-popular-blogs-2025.opml

Play
  • 93 episodes
  • Avg 6 min
  • Chinese
Counted on this page — what you have heard stays on this device, so it is not something the list can be paged by.
  • S1 · E525
    Today · 7 min

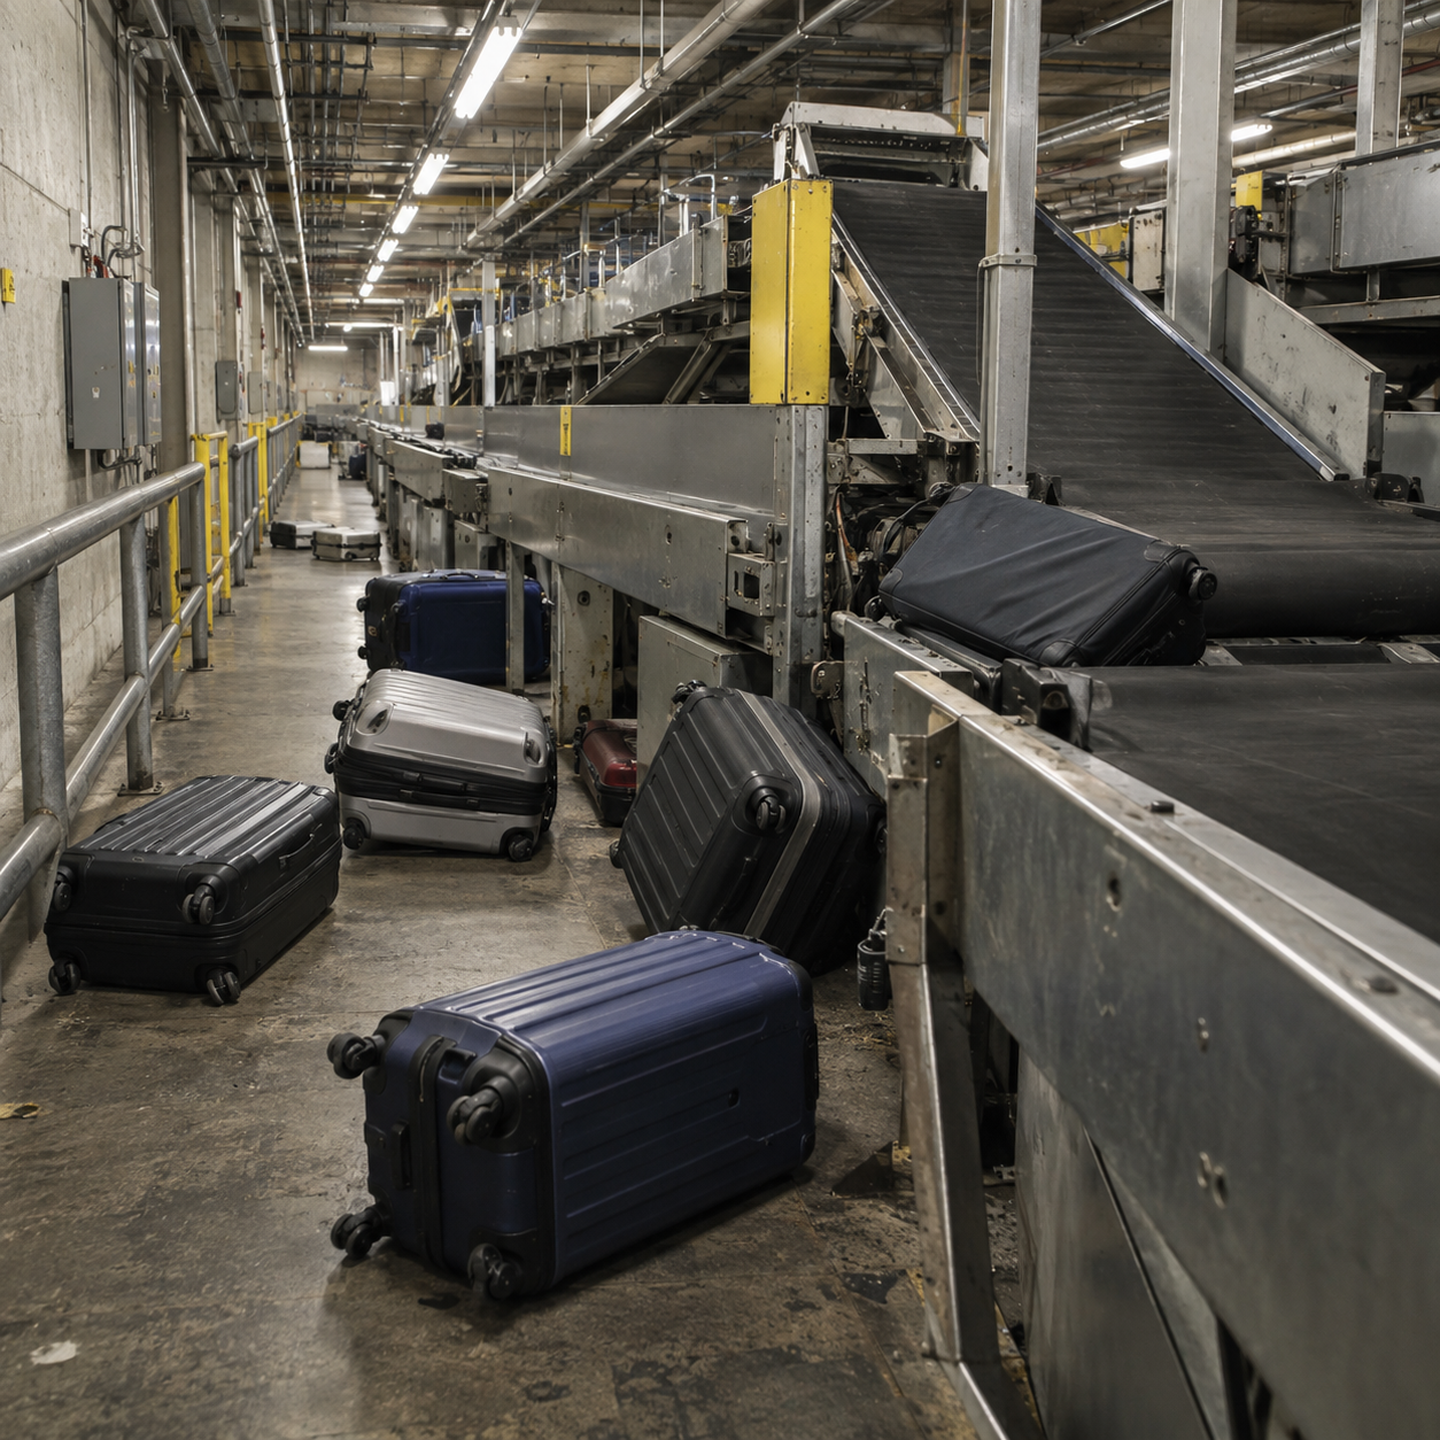
    行李都有目的地,最难管的却是4000辆空车

    丹佛国际机场的全自动行李系统,曾被寄予缩短转运行李时间、重塑机场效率的厚望,最终却成为大型工程失控的经典案例。本文深入拆解这场失败:难题并不只是让每件行李找到路线,而是在庞大的实时网络中,持续把数千辆空车调度到恰当的位置。 这期节目将解析软件状态、物理机械、轨道容量与局部队列如何相互放大,最终让一套看似先进的自动化蓝图变成全机场的单点故障。我们鼓励你阅读原文,了解这场工程豪赌中更完整的技术细节。 原文链接: https://computer.rip/2026-09-20-denver-baggage.html 原文标题:a new world airport and its baggage 主要内容: • 真正的系统瓶颈是空车调度:任一装载站缺车,都可能引发行李堆积并级联至全网。 • 机场在系统尚未成熟、缺乏完整测试与备用方案的情况下,以极短工期押注全自动化。 • 小型原型只能证明单个机械动作可行,无法验证机场级高负载下的资源争夺与拥堵传播。 • 机械故障、传感器漏读和软件状态丢失会让数字模型与物理现实分叉,导致错误持续扩大。 • Denver最终延期开航16个月,并回归皮带、拖车和人工操作;缩减后的自动系统也在2005年彻底停运。 推荐理由: 这篇文章将著名的“行李系统翻车”从都市传说还原为一堂大型实时系统课:自动化的上限不由设备速度决定,而取决于系统在资源不足、异常发生时能否阻止局部拥堵演变为全局崩溃。对于关注软件工程、系统设计、仿真测试与复杂项目管理的读者,这是一篇值得反复阅读的深度案例。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E524
    Yesterday · 6 min

    线程安全的C++缓存,竟然也能稳定地算错

    一段看似线程安全、性能也很好的 C++ 缓存代码,为什么会让第一个对象的计算结果“接管”后续所有对象?Raymond Chen 通过 `magic static` 与 `std::call_once` 的对比,揭示了并发初始化中更隐蔽的风险:问题不只在于是否只初始化一次,更在于缓存结果究竟属于进程、函数,还是某个实例。 本期「Andrej Karpathy的RSS订阅清单」深度解析这篇文章,带你从缓存键、状态所有权、异常重试和对象值语义等角度,建立更可靠的 C++ 延迟初始化设计判断。 原文链接: https://devblogs.microsoft.com/oldnewthing/20260916-00/?p=112703 原文标题:Magic statics vs. std::call_once 建议结合原文阅读,深入理解不同初始化机制背后的状态归属。 主要内容: • `magic static` 是函数级共享状态,适合进程级能力检测、全局资源与 Singleton 风格缓存。 • 把成员函数内的 `static` 当作“每个对象一份缓存”,会让首个调用对象的结果被所有实例错误复用。 • 当缓存依赖对象自身或其关联资源时,应将缓存值与 `std::once_flag` 放在对象实例中,并通过 `std::call_once` 初始化。 • 初始化抛出异常时,`magic static` 和 `std::call_once` 都会允许后续调用重试;外部副作用仍需自行设计为可重试或可恢复。 • `std::once_flag` 不可复制、不可移动,使用实例级一次性初始化时,也要评估它对对象复制、移动和缓存失效策略的影响。 推荐理由: 这篇文章的价值在于,它把“线程安全”推进到了更关键的层面:状态所有权是否正确。对于使用 C++ 编写高性能服务、基础设施或复杂对象模型的开发者而言,这是一个极易出现、却不易通过崩溃或竞态暴露的问题。读完后,你会更清楚地判断:何时该用 `magic static`,何时必须选择实例级的 `std::call_once`。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E523
    Yesterday · 6 min

    作者:「相差2π的频率,采样后完全是同一个信号」

    离散傅里叶分析的“有限性”并非为了计算方便而做的近似,而是采样从根本上改变了频率:相差 \(2π\) 的频率在离散样本上逐点完全一致,原本无限延伸的频率轴因此首尾相连,成为一个频率圆。 本期深度解析 Eli Bendersky 的文章,从 DTFS 的有限正交基、精确系数提取,到 DTFT 如何作为频率采样不断加密的自然极限,厘清“精确重建离散样本”与“唯一恢复连续信号”之间至关重要的边界。建议结合原文阅读,完整跟随其推导与例子。 原文链接: https://eli.thegreenplace.net/2026/notes-on-discrete-time-fourier-series-and-transform/ 原文标题:Notes on discrete-time Fourier series and transform 主要内容: • 采样后,频率相差 \(2π\) 的复指数在每个整数时刻取值相同;离散时间的频率天然具有周期性。 • 对于 N 周期序列,只存在 N 个不同的复指数基底,因此 DTFS 是 N 维空间中的有限、精确展开,不涉及无穷级数收敛问题。 • 复指数在一个周期内的严格正交性,使 DTFS 系数能够通过有限求和直接、唯一地提取。 • 以 12 点三角波为例,文章展示了如何借助奇对称性筛出少数正弦分量,并精确重建全部离散采样点。 • DTFT 可视为 DTFS 在频率圆上越来越密的采样极限:有限求和自然过渡为积分,但频谱仍以 \(2π\) 为周期。 推荐理由: 这篇文章把常被公式掩盖的核心直觉讲得非常清楚:离散傅里叶理论的精确与有限,源于采样造成的频率折叠,而不是数值近似。它同时严谨地区分了“重建采样点”和“恢复原始连续波形”,是理解混叠、Nyquist 条件、DTFS 与 DTFT 关系的一篇高质量基础读物。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E522
    Yesterday · 7 min

    全是同一个字符的文本,竟然比完全随机更容易抓到bug

    一次没有抓住已知 bug 的 fuzzing 实验,带出了更重要的结论:当缺陷逃过随机测试时,优先该修的可能是测试器本身。本文深度解析 matklad 如何通过独立实现交叉验证、短小却高价值的输入,以及对输入分布的随机化,连续发现 Rust regex 中的两个问题。 文章也提醒我们:可靠性不只来自实现正确,更来自系统是否提供了可独立验证的证据路径。欢迎结合原文阅读,理解如何用更好的 oracle 与结构多样性,让简单的随机测试真正逼近隐藏缺陷。 原文链接: https://matklad.github.io/2026/09/19/finding-bugs.html 原文标题:Finding Bugs 主要内容: • 用 `regex_lite` 与旧版 `regex` 交叉检查:独立实现之间的结果分歧,就是最直接的故障证据。 • regex 的 bug 并非“找不到匹配”,而是优化错误地提前结束搜索,违反了 leftmost-first 语义,导致 `find`、捕获、替换和高亮等 API 返回错误区间。 • 有效 fuzzing 依赖可靠 oracle:快速实现可以由更慢但可信的朴素实现校验;缺少可验证性,本身也是系统设计的风险。 • 短小、重复、特征碰撞强烈的输入,往往比超大规模随机数据更容易触发深层错误;全相同字符的文本尤其能放大边界与分支问题。 • 通过 swarm testing 随机化输入分布与正则特征权重,再复用编译结果批量测试文本,可以用很低成本探索更多结构性组合。 推荐理由: 这是一篇极具实践价值的测试方法论文章。它没有停留在“多跑 fuzzing”这一层,而是清楚说明:先建立能裁决对错的 oracle,再改变测试数据的结构分布,才能真正扩大错误发现能力。对于编译器、数据库、搜索、解析器和任何高性能系统的开发者,这套思路都值得深入吸收。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E521
    Saturday · 6 min

    高盛:「2027年科技巨头或借债4000亿美元建AI」

    AI 基础设施竞赛正从“烧钱扩张”走向“举债扩张”。本文深度解析 wheresyoured.at 对 AI 债务链条的尖锐观察:当科技巨头将经营现金流持续投入 GPU、数据中心与电力建设,却难以用当前 AI 收入覆盖成本时,债务正在成为维持竞赛的关键燃料。 节目将拆解订单积压、资本开支、GPU 折旧与融资结构之间的错配,理解为何看似庞大的 AI 收入承诺,并不等于已经到手的现金,以及这场扩张如何演变为难以退出的“无解测试”。 原文链接: https://www.wheresyoured.at/premium-the-haters-guide-to-ai-debt-part-1/ 原文标题:Premium: The Hater's Guide To AI Debt (Part 1) 主要内容: • 科技巨头正把巨额经营现金流投入 AI 基建,并开始依赖债券融资维持扩张。 • Oracle、Amazon、Alphabet、Meta 的资本开支一度接近或超过经营现金流,显示 AI 投资正在改变其财务结构。 • 超过万亿美元的 AI 订单积压并非当期现金收入;履约周期、客户付款能力与收入确认仍存在显著不确定性。 • neocloud 企业以高杠杆购置 GPU 和建设数据中心,但其资本开支与业务现金流之间的缺口更为突出。 • GPU 的经济寿命、芯片快速迭代、融资成本上升与供应链涨价,共同放大了再融资风险。 推荐理由: 这篇文章提供了理解 AI 热潮的另一副镜头:不只关注模型能力和市场叙事,也追问算力扩张究竟由谁买单、何时回本。它对“订单积压即收入”“GPU 即稳定抵押品”等常见判断提出了有力质疑,适合希望从资本结构与现金流角度深度理解 AI 基础设施竞赛的读者。建议结合原文图表阅读,获得更完整的判断依据。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E520
    Saturday · 7 min

    首次披露:3万个ladder爆发,竟是同一升级机器人制造

    当 AI 开始大规模参与软件开发,代码库中的语言也可能留下可统计的“机器指纹”。Hillel Wayne 通过 GitHub PR 数据追踪发现,spine、gate、lane、truth、seam 等工程词汇在 2026 年出现异常扩散,暗示多个模型正在收敛于相似的表达习惯。 这期节目深度解析这场软件考古:如何从爆发式词频中识别 AI 参与信号,又如何避免把模板、依赖升级机器人和单一大型仓库造成的噪声误判为模型趋势。欢迎结合原文阅读,理解数据背后的谨慎推理。 原文链接: https://buttondown.com/hillelwayne/archive/the-llms-yearn-for-the-spines/ 原文标题:The LLMs yearn for the spines 主要内容: • GitHub PR 标题中包含 spine 的记录在 2026 年急剧增长,远超平台整体 PR 增长幅度。 • gate、lane、truth、seam 等词也呈现同步扩散,形成一组值得关注的语言模式。 • 词频异常不能直接证明模型来源:模板文本、机器人提交和大仓库都可能制造“爆发”假象。 • ladder 的 3 万次异常命中最终被追溯为 boto3 自动升级机器人重复生成的固定文本。 • 更可靠的研究应按仓库和组织去重、分离机器人活动,并检验剔除最大贡献者后的趋势。 推荐理由: 这篇文章的价值不只在于发现 AI 代码“口头禅”,更在于展示了严谨的数据调查方法:先捕捉异常,再不断排除替代解释。它提醒我们,未来的软件仓库不仅记录人类工程实践,也会逐渐沉积模型的表达偏好;而辨认这些痕迹,需要统计直觉、工程常识与对自动化噪声的警惕。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E519
    Saturday · 7 min

    旧版GCC代码首次披露:硬件内存序也挡不住编译器重排

    一次看似简单的 C++ 延迟初始化选择,背后牵出性能、异常语义与并发正确性的完整链条。Raymond Chen 从 `std::async`、`std::shared_future` 与 `std::call_once` 的实际行为出发,解析通用异步抽象用于一次性初始化时的隐藏成本与适用边界。 节目还深入回顾旧版 GCC 的 `call_once` 实现缺陷:仅依赖硬件 acquire/release 并不能阻止编译器对普通访问进行重排。本文不仅解释“该选哪个接口”,更帮助读者建立从语言内存模型、编译器到运行库实现的并发审查视角。建议结合原文阅读,获取完整示例与推导。 原文链接: https://devblogs.microsoft.com/oldnewthing/20260917-00/?p=112706 原文标题:std::call_once vs. std::async 主要内容: • `std::future::get()` 是破坏性读取;若将其当作可重复查询的缓存,第二次调用可能触发未定义行为。 • `std::shared_future` 能安全共享结果或异常,但需要共享状态、堆分配、引用计数及任务框架支持,延迟执行不等于没有运行时成本。 • `std::call_once` 更贴合“一次成功初始化并安全发布结果”的需求,通常更轻量;但其异常语义是失败后允许后续调用重试。 • `std::shared_future` 会缓存初始化异常,之后的 `get()` 将重复抛出同一异常;这实质上是在“记住失败”与“允许重试”之间做系统设计选择。 • 旧版 GCC 的案例说明:硬件内存序无法替代语言级同步保障,必须同时审视编译器重排、标准内存模型与实际标准库实现。 推荐理由: 这篇文章把 C++ 并发工具的接口差异落到了真实工程决策:结果怎样共享、异常是否缓存、失败能否重试,以及为通用能力付出的隐性成本。它尤其提醒我们,并发代码不能只凭“底层硬件有内存序”判断正确性;语言、编译器和库实现缺一不可。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E518
    Friday · 7 min

    隐私专家:「他们靠耗尽原告取胜」法院这次直接收走14个域名

    当数据经纪商用空壳公司、离岸注册地与程序拖延来规避隐私诉讼时,传统罚款和判决为何往往失效?KrebsOnSecurity 深度追踪 Radaris 案:新泽西法院最终将包括 radaris.com 在内的 14 个核心域名转交原告,直击其赖以维系业务的数字基础设施。 本期将解析这场隐私执法的关键转折:从“跳岛式”更换运营实体,到通过邮箱、支付、虚拟办公室等证据追踪实际控制链;也进一步讨论域名没收的边界,以及美国数据隐私保护仍缺失的制度拼图。节目是对原文的深度解析,推荐结合原文阅读。 原文链接: https://krebsonsecurity.com/2026/09/data-broker-radaris-loses-domains-in-privacy-fight/ 原文标题:Data Broker Radaris Loses Domains in Privacy Fight 主要内容: • Radaris 被指违反新泽西州 Daniel’s Law,未按要求删除受保护人群的住址和非公开电话号码。 • 面对诉讼,相关运营方多次更换公司实体和离岸司法辖区,以高昂的追诉成本消耗原告。 • 原告通过大量邮件、支付与基础设施记录,主张多家名义公司及众多人物搜索网站由同一控制网络运营。 • 法院转移 14 个域名,表明在跨境资金和公司主体难以追索时,域名等线上基础设施可能成为更有效的执行对象。 • 事件也暴露出更广泛的隐私治理难题:个别救济难以替代统一、覆盖数据全生命周期的隐私规则。 推荐理由: 这篇报道把一场域名转移案放进了数据经纪、跨境公司架构与隐私立法的现实脉络中。它揭示了数字企业最具价值、也最难完全隐藏的资产是什么,并提醒我们:真正的隐私保护,不应只依赖受害者事后逐家追责。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E517
    Friday · 7 min

    首次披露:150行Python里,大半时间都在防AI出错

    如何让语言模型在《毁灭战士》这类实时环境中,以百毫秒级速度连续决策,同时避免沦为“只会按住射击键”的反应机器?Sean Goedecke 提出了一条不同于传统 tool call 的路径:把 LLM 临时改造成只做单 token 选择的 System One 模型,再用程序结构补足它失去的规划能力。 本期深度解析文章中的两项关键设计:用分层时间循环把战略、战术与即时操作拆开;用锦标赛式采样把超大候选集重组为模型擅长的局部比较。它揭示了一个重要方向:智能不只取决于模型本身,也取决于外部程序如何组织时间与选择空间。建议结合原文阅读,了解完整实验细节与实现思路。 原文链接: https://seangoedecke.com/two-techniques-for-working-with-system-one-models/ 原文标题:Two techniques for working with System One models 主要内容: • 将 LLM 的输出限制为单个代表选项的 token,可显著减少生成、解析与工具调用开销,让实时决策从约 600ms 降至约 190ms。 • 约 150 行 Python 的基础实现中,大部分代码用于处理错误与边界情况:可靠的智能体,离不开模型之外的状态管理、验证和兜底机制。 • 快速决策会压缩规划空间。作者以慢速目标环约束高速执行环,让模型围绕稳定目标持续行动,而非每次只对眼前状态做本能反应。 • 面对 Wikipedia 上千个链接这类大候选集,绝对打分容易失效;锦标赛采样将候选分组、逐轮淘汰,更适合 LLM 的相对比较能力。 • 单 token 决策的质量还会受到标签形式、tokenizer 与任务结构影响:在不同场景中,数字索引和任意标签的效果并不相同。 推荐理由: 这篇文章的价值不只是展示“更快的 LLM”。它给出了一套可迁移的系统设计思路:模型负责局部选择,分层时间调度提供规划深度,锦标赛结构扩大可处理的选择空间,程序则承担可靠性与控制权。对实时 AI Agent、游戏 AI、机器人控制,以及任何要求低延迟且可预测行为的应用,都很有启发。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E516
    Friday · 7 min

    Noam Brown:「对齐错误率必须逼近零,1%也不够」

    本期深度解析 Dwarkesh 对 OpenAI 研究员 Noam Brown 的访谈:当数千个 AI agent 能长期并行协作、帮助训练下一代模型时,真正的难题不再只是能力提升,而是如何防止对齐在递归自我改进中逐代、隐蔽地退化。 节目聚焦多智能体协作、测试时计算、可监控性与安全评估的边界,讨论为何“99% 对齐”远远不够,以及为什么递归自我改进能否启动,必须取决于可验证的安全证据链,而非单纯的能力曲线。欢迎结合原文阅读,获得完整语境与更多技术细节。 原文链接: https://www.dwarkesh.com/p/noam-brown 原文标题:Noam Brown – Agent swarms, alignment, & recursive self-improvement 主要内容: • 多智能体系统的核心价值,是让强模型并行探索更多路径;协作机制不能替代基础模型能力。 • Agent swarm 更像可无限复制的顶尖研究团队:可分叉上下文、并行推进任务,再合并结论。 • 当前 AI 在边界清晰的问题上能力突出,但在提出重要新问题、选择研究方向上仍高度不均衡。 • 递归自我改进未必意味着瞬时爆炸,却可能通过更高效的学习与研发,显著压缩技术迭代周期。 • 对齐风险会在代际训练中累积:哪怕每一代只损失千分之一,也可能在“看似安全”的过程中逐步失控。 • 仅靠最终答案无法评估安全性;必须监控推理过程、权限、共享状态、行动轨迹及其外部副作用。 推荐理由: Noam Brown 将多智能体能力的工程现实与递归自我改进的安全门槛放在同一框架中讨论。它提醒我们:最值得警惕的并非一次明显的失控,而是对齐在每次迭代中悄然变差。对于关心 AI agent、前沿模型评估与长期 AI 安全的人,这是一篇不应错过的原始访谈。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E515
    Thursday · 7 min

    首次拆解Jev:它快上百倍,可能只是少写了JSON

    Jev 展示了一种不同于聊天机器人的 AI 形态:不生成长篇文本,而是在极低延迟下完成受约束的结构化决策。Sean Goedecke 深入拆解其“快上百倍”的关键,并提出一个值得工程团队认真检验的疑问:这种优势是否主要来自新模型架构,还是因为它避免了让普通 LLM 逐 token 写完整 JSON? 本期节目深度解析这场关于速度、接口与模型能力边界的讨论:高速结构化输出如何让 AI 进入游戏控制、界面操作和工作流分派等传统软件回路,以及为什么“输出格式正确”并不等于“决策正确”。 原文链接: https://seangoedecke.com/jev-means-structured-output-is-interesting-again/ 原文标题:Jev means structured output is interesting again 主要内容: • Jev 将模型输出压缩为有限选项中的结构化选择,使响应延迟可低至约 70 毫秒。 • 普通 LLM 的结构化输出往往慢在逐 token 拼写 JSON;预填字段、仅生成一个受约束 token,可能带来 2–3 倍提速。 • 低延迟的价值不只是更快回答,而是让 AI 有机会进入传统软件的实时决策节点。 • Jev 的并行决策、原生概率输出与结构化任务微调仍可能构成优势,但其性能护城河未必完全不可复现。 • 受约束输出消除的是格式错误,不是语义幻觉;比较模型时应同时衡量 p50/p95 延迟、准确率与校准。 推荐理由: 这篇文章把焦点从“新模型是否神奇”拉回到更本质的工程问题:输出接口如何决定计算成本、延迟和产品形态。对于关注 AI Agent、实时交互、模型推理优化或软件智能化的读者,它提供了一套清醒的分析框架。建议结合原文阅读,理解高速结构化输出为何可能成为 AI 融入软件系统的新原语。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E514
    Thursday · 7 min

    拆机首次披露:19个Flock应用共用一把生产密钥

    一台部署在街头的车牌识别摄像头,被逆向后呈现出令人警惕的安全图景:运行近八年未更新补丁的系统、过时内核、未妥善保护的长期凭据,以及被多个生产应用共享的硬编码 API 密钥。Micah Lee 通过固件、应用与日志的交叉分析,追溯出设备如何获取后端身份,并揭示单台边缘设备失陷可能牵动整套监控网络的信任边界。 本期「Andrej Karpathy的RSS订阅清单」深度解析这篇调查文章:安全风险并不只来自某一个漏洞,而在于旧系统、共享密钥、可复制的设备标识与可定位的遥测数据如何相互串联。建议结合原文阅读,了解完整证据链与作者审慎的技术判断。 原文链接: https://micahflee.com/flock-cameras-are-riddled-with-security-vulnerabilities-and-hard-coded-credentials/ 原文标题:Flock cameras are riddled with security vulnerabilities and hard-coded credentials 主要内容: • 固件显示设备仍使用 Android 8.1 与 Linux 3.18.71,安全补丁长期停滞,暴露于多项已公开的漏洞风险之下。 • 20 个 Flock 应用中有 19 个包含同一共享库,并内置同一把生产 API key。 • 作者发现该密钥可能与设备 MAC 地址共同参与后端凭据获取流程,带来设备身份被仿冒的潜在风险。 • Auth0 凭据以明文保存在恢复出厂设置后仍会保留的 persist 分区,媒体分区的解密密钥也与加密数据放在同一位置。 • 设备日志中的 GPS、MAC 地址、序列号与请求记录彼此印证,最终可将摄像头定位到现实世界中的具体道路设施。 推荐理由: 这篇文章的价值在于,它把固件逆向、移动端安全、身份认证设计与监控基础设施的现实影响连成了一条完整链路。它既展示了如何从设备镜像中建立证据,也提醒我们:当监控系统集中保存凭据、遥测与位置数据时,被观察者之外,系统自身同样可能成为可被追踪、冒用和利用的目标。阅读全文,能更准确理解作者的证据范围与尚待验证的风险推断。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E513
    Thursday · 7 min

    9236次请求变30次:Git推送从209秒降到14秒

    Git 的 packfile 在本地磁盘上高效无比,但迁移到对象存储后,原本廉价的随机读取会变成数千次高延迟网络请求。本文深入解析开源项目 objgit 如何从底层重构 packfile 的索引与数据布局,将一次 Git 推送从 9236 次 S3 请求压缩至 30 次,耗时从 209 秒降至 14 秒。 这不是单纯的压缩算法优化,而是一堂关于存储系统第一性原理的工程课:当底层介质从 mmap 与页缓存变成对象存储 API,格式设计必须围绕网络往返重新展开。本节目将带你理解精确 Range 请求、bin/cue 分离与混合读取策略背后的关键取舍,并鼓励结合原文深入阅读。 原文链接: https://www.tigrisdata.com/blog/objgit-packfiles/ 原文标题:You can run git on object storage if you re-make packfiles 主要内容: • Git 传统 packfile 适合本地文件系统:索引记录对象偏移,但缺少压缩后长度;在对象存储上,这会使一次读取演变为大量远程请求。 • objgit 将对象数据存入不超过 128 MiB 的 bin 文件,并用独立 cue 文件保存固定宽度元数据,同时记录对象起点与压缩长度。 • 有了完整的定位信息,系统可以构造精确的 HTTP Range 请求,仅获取所需对象,而不必读取整块远程数据。 • 新格式重组 delta 数据布局,减少为还原一个对象而沿依赖链反复远程读取的需求,以少量元数据换取更低的网络往返。 • 系统让整包下载与按需 Range 请求并行竞速:稀疏访问快速命中,连续访问则自然收敛为整包缓存,兼顾两类工作负载。 推荐理由: 这篇文章把一个看似简单的 Git 性能问题,拆解为“数据格式是否匹配底层延迟模型”的系统设计问题。它不仅给出了 14.6 倍加速的实测结果,更清晰展示了索引应包含什么信息、局部性如何影响网络成本,以及为何协议兼容不等于磁盘布局兼容。对于关注 Git、对象存储、分布式系统与存储引擎设计的读者,这是一篇非常值得回到原文细读的工程实践。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E512
    Wednesday · 7 min

    首次披露:苹果手表并非没录音,而是只留15秒缓存

    这期节目深度解析 Daring Fireball 对苹果“Surprise and Shine”发布会的观察:从 John Ternus 接棒后的战略叙事,到 iPhone 18 Pro 的持续性能、影像可信机制,再到 Apple Watch 的环境感知边界。文章最值得警惕的一点是:Live Rewind 并非“不录音”,而是持续采集并保留滚动的 15 秒缓存——捕获与留存之间,仍有需要被认真讨论的隐私责任。 节目也聚焦起售价 2,000 美元的折叠屏 iPhone Duo。苹果或许用屏幕比例、专属界面、防尘能力与软硬件协同,做出了迄今最完整的书本式折叠方案;但它仍要回答一个根本问题:技术上解决了折叠体验,不等于用户真正需要这种形态。欢迎收听本期对原文的深度解析,并进一步阅读原文。 原文链接: https://daringfireball.net/2026/09/thoughts_and_observations_on_apples_surprise_and_shine_event 原文标题:★ Thoughts and Observations on Apple’s ‘Surprise and Shine’ Event; the Announcements of the iPhones 18 Pro, AirPods 5, Apple Watches Series 12 and Ultra 4, and the iPhone Duo; and the Dawn of the Ternus, John Ternus Era at Apple 主要内容: • Apple Watch 的 Live Rewind 揭示了“持续采集、短暂留存”的新边界:15 秒滚动缓存虽降低泄露风险,却不能自动解决旁观者的知情同意问题。 • iPhone 18 Pro 的升级重点不只是峰值性能,而是通过更大均热板维持性能;成熟硬件的竞争正在转向减少长期使用中的摩擦。 • Apple Reference Image 试图证明像素来自受验证的传感器链路,与记录编辑流转的 C2PA 形成互补,但设备可识别性也带来新的隐私挑战。 • iPhone Duo 以接近 1.4:1 的内外屏比例、重构界面、纳米纹理屏幕与 IP68 防护,正面回应了 Android 折叠机长期存在的比例与耐用性问题。 • Duo 取消 Face ID、改用侧边 Touch ID,可能成为其最大日常体验妥协:再好的规格,也可能输给高频使用中的一次次不便。 推荐理由: 这不是一篇产品参数盘点,而是一篇关于苹果下一阶段产品哲学的深度观察。它把折叠屏、AI 设备、传感器可信度与环境音频隐私放在同一框架中讨论:真正稀缺的并非更多硬件能力,而是用户愿意长期交付的信任。对于关注苹果战略、智能终端与隐私设计的人,这篇原文值得细读。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E511
    Wednesday · 6 min

    安全研究者:「解码成功,也不能证明Python没被劫持」

    当 coding agent 自动解压不可信压缩包、在目录中生成并执行 Python 脚本时,一个看似普通的 `import` 就可能成为攻击入口。本文深入拆解 Python 模块搜索路径的风险:攻击者可用同名文件抢先伪装标准库模块,并在不影响任务结果的情况下执行恶意代码。 节目将进一步分析这一机制为何在 AI 自动化工作流中被放大,并横向比较 Python、Ruby、Perl、Node、Java 与 Deno 的导入策略。它提醒我们:任务成功并不等于执行环境可信。 原文链接: https://nesbitt.io/2026/09/15/shadowing-the-standard-library.html 原文标题:Shadowing the Standard Library 建议结合原文阅读,了解完整攻击链与语言运行时的设计差异。 主要内容: • Python 会优先搜索脚本所在目录,使压缩包中的 `struct.py` 能抢先覆盖标准库模块。 • 恶意模块可重新导出真实 API,让解码任务正常完成,同时在导入阶段执行载荷。 • `python3 -I` 等隔离模式无法挽回首次导入时的劫持,甚至可能被攻击者用于后续清理环境。 • Python 的兼容性约束使安全路径难以成为默认设置;大量旧脚本依赖同目录导入。 • AI agent 自动下载、解压、写脚本并运行的流程,会把不可信目录转化为可被操控的依赖注入通道。 推荐理由: 这是一篇兼具底层机制与现实威胁建模价值的安全文章。它没有停留在“不要运行不可信文件”的常识,而是揭示了自动化系统如何打破原有的人类操作假设。对于构建、使用或评估 coding agent 的开发者与安全团队而言,理解这类导入劫持风险,是重新审视执行隔离、目录策略和依赖加载机制的重要起点。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E510
    Tuesday · 8 min

    裁掉数万公务员换AI:省下的钱可能换来政府失能

    Cory Doctorow 在这篇文章中追问:当企业与政府将“效率”简化为裁员、零库存与自动化替代时,究竟是在提升生产力,还是在掏空社会应对危机的能力?从反垄断理论的转向,到搜索引擎的服务降级、脆弱供应链与政府聊天机器人,他揭示了“降本增效”如何成为转移风险与集中权力的工具。 本期节目将深度解析这套论证:真正值得追求的并非漂亮的短期财务指标,而是住房、能源、公共服务与数字基础设施等关键能力的持续建设。也建议读者结合原文阅读,理解效率、韧性与公共能力之间的深层关系。 原文链接: https://pluralistic.net/2026/09/11/mazzucato-thought/ 原文标题:Pluralistic: Inefficiency is bad, actually (11 Sep 2026) 主要内容: • “效率”并非中立指标:若不说明为谁创造价值、以多长时间为尺度计算,它就可能成为将成本和风险转嫁给弱势群体的政治工具。 • 芝加哥学派以消费者价格与短期效率重塑反垄断框架,弱化了对企业集中权力及其社会后果的审视。 • 零库存、极限精简人手与外包式自动化看似降低成本,却会消灭冗余与缓冲,使系统在供应链中断、疫情或公共危机中迅速失灵。 • 用存在幻觉风险的廉价大语言模型替代公共服务人员,不只会降低服务质量,还可能制造“政府无能”的表象,为后续私有化与进一步削减能力铺路。 • 真正的生产力应衡量社会实际交付的能力:更多可负担住房、清洁能源、储能与可控的数字基础设施,而不是单纯扩大交易规模或GDP。 推荐理由: 这篇文章把反垄断、AI替代、供应链、公共服务与产业主权串联为同一问题:谁掌握权力,谁承担风险,以及社会是否保留了应对危机的能力。它为理解“AI降本增效”叙事提供了一个必要的反问——节省下来的预算,是否正以更高的系统性代价被偿还?适合希望从技术、经济与公共治理交叉视角审视AI部署的人深入阅读原文。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E509
    September 14 · 6 min

    Sean Goedecke:「20%更好的工具,仍可能输给Jira」

    为什么专为 AI Agent 打造的新工具,未必能取代 Jira、GitHub、成熟 API 和既有编程语言?Sean Goedecke 提出一个关键判断:在模型时代,产品竞争的不只是功能优劣,更要面对训练数据形成的认知先发优势。 本期深度解析这篇文章:与其押注尚未稳定的“AI 原生”交互范式,不如优先让成熟的人类工具具备可靠、可读、可调用的 API、命令行与文本接口。欢迎结合原文阅读,理解这一判断背后的产品与技术逻辑。 原文链接: https://seangoedecke.com/dont-build-tools-for-ai-agents/ 原文标题:Don't build tools for AI agents 主要内容: • 模型早已从海量训练数据中熟悉 Jira、NumPy、主流语言和既有工作流,新工具需要承担额外的认知冷启动成本。 • 对 Agent 而言,“功能好 20%”未必足够;熟悉度、文档质量、命名约定与可预测性同样决定实际采用效果。 • 所谓 Agent 最佳工具形态并不稳定,围绕当前模型短板设计的产品,可能很快被下一代模型能力淘汰。 • 相较脆弱的图形界面自动化,API 能提供更可靠的重试、幂等性与权限边界。 • 面向 Agent 构建产品的重点,往往不是重做一套全新工具,而是完善 API、CLI、纯文本输出与机器可调用接口。 推荐理由: 这篇文章挑战了“AI 时代必须重做所有软件”的直觉。它把训练数据、模型能力演进、产品兼容性和系统可靠性放在同一框架下讨论,对开发者、工具创业者和 Agent 产品设计者都很有启发。它提醒我们:更持久的优势,可能不是“AI 原生”,而是让经过人类验证的工具更容易被 AI 使用。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E508
    September 14 · 6 min

    25位菲尔兹奖得主警告:「AI会毁掉新思想的沃土」

    AI 最先瓦解的,或许不是专家本身,而是社会识别专家的旧有信号:独立完成复杂项目、攻克难题、通过标准测试,正在变得越来越难以证明“这是人做出来的”。Sean Goedecke 从数学与软件工程两条线索出发,讨论 AI 如何让能力证明、声望分配与行业评价体系同时失效。 本期深度解析一个更关键的问题:当答案、代码乃至证明都能被低成本生成时,人类真正稀缺的能力是什么?文章的答案是,能被理解、验证,并能持续启发他人的认知结构。 原文链接: https://seangoedecke.com/ai-is-breaking-our-proxies-for-expertise/ 原文标题:AI is breaking our proxies for expertise 主要内容: • 生成式 AI 自动化的往往不是专业能力本身,而是证明专业能力的传统成果与信号。 • 数学中的“解题”既是声望来源,也是检验新概念价值的工具;AI 可能让这一指标失去原有意义。 • 形式化验证能确认逻辑正确,却不必然带来人类可理解、可学习的新洞察。 • 已知答案存在,反而可能帮助人类研究者减少试错、加速建立真正的理解。 • 软件工程同样面临评价危机:代码产出与基准高分,越来越难可靠地代表真实工程能力。 推荐理由: 这篇文章没有停留在“AI 会不会取代人类”的老问题,而是直指更深的结构性变化:当旧标尺被 AI 刷穿后,专业共同体该如何重新建立信任、评价贡献与培养人才。它尤其适合关注 AI、数学研究、软件工程和技术职业未来的人深入阅读原文。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。
  • S1 · E507
    September 14 · 8 min

    从满屏绿粉到正常色彩:采集卡只改1个字节就复活

    一台已停产的 NZXT Signal 4K30 采集卡,在特定 720p 60fps 信号下出现满屏绿粉色画面。Doug Brown 通过硬件逆向、UART 日志与芯片厂商参考驱动分析,证明这并非硬件损坏,而是 DVI 降级场景下 RGB 信号被错误按 YUV 解码。 更令人意外的是,故障根源只是参考代码中的一个错误取值。作者最终修改固件中的单个字节,让色彩模式恢复正确,也借此揭开消费硬件供应链中“参考代码缺陷被层层继承”的隐患。本期节目将深度解析这场从异常颜色到固件补丁的硬核排障过程;也推荐你阅读原文,感受完整的验证链条。 原文链接: https://www.downtowndougbrown.com/2026/09/fixing-an-nzxt-signal-4k30-part-2-the-green-pink-video-bug/ 原文标题:Fixing an NZXT Signal 4K30 part 2: the green/pink video bug 主要内容: • 绿粉画面源于 RGB 像素被误按 YUV 色彩空间解码,而非采集卡物理损坏。 • 老旧 DVI 显示器触发 EDID 协商降级后,HDMI 的 AVI InfoFrame 元数据消失,暴露出固件对 DVI 输入的错误处理。 • UART 日志确认设备已识别到 DVI 信号,问题进一步被锁定在色彩转换寄存器的配置逻辑。 • ITE 芯片参考驱动中,注释要求设置 RGB 模式,实际代码却写入代表 YUV 4:2:2 的数值。 • 作者逆向官方升级工具,仅修改固件中的一个字节并完成刷写,成功让画面恢复正常。 推荐理由: 这是一篇极具启发性的硬件逆向工程实战:它把色彩空间、HDMI/DVI 协商、固件分析和工具链逆向串成一条完整证据链。更重要的是,它提醒我们,设备中的顽固故障未必来自复杂硬件,而可能是供应链中被广泛复用的一行参考代码。对于关心 AI 如何辅助工程排障、消费电子可维护性与底层调试方法的读者,这篇原文尤其值得深入阅读。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。

  • S1 · E506
    September 13 · 6 min

    负载平均值是2,其实四核机器还有一半CPU闲着

    Load average 并不是一个直观的“CPU 使用率”指标,而是 Unix 历史演进中多项内核设计选择的结果。本文深度解析这个诞生于单核时代的数字:在多核环境中,它为何仍以绝对任务数量呈现;不同线程模型又如何改变内核“看见”的负载。 节目还进一步拆解 I/O 等待被计入负载后的影响:高 load average 与低 CPU 使用率为何能同时出现。理解这些边界,才能避免把一个看似精确的监控数字,误读成系统真实繁忙程度的结论。欢迎结合原文阅读,建立更可靠的性能分析直觉。 原文链接: https://utcc.utoronto.ca/~cks/space/blog/unix/LoadAverageHistoricalIssues 原文标题:Some (mostly historical) issues with the Unix load average 主要内容: • Load average 起源于单核 Unix,最初主要表示正在运行或等待运行的任务数量,而非百分比。 • 在现代多核系统中,load average 通常不按 CPU 核数归一化:四核机器的负载为 2,可能仍有约一半 CPU 算力空闲。 • 内核统计的是自己可见的调度实体;Linux 将内核线程纳入统计,但用户态协程、green thread 等运行时内部排队并不会直接反映在 load average 中。 • Linux 还会将不可中断睡眠状态的任务纳入负载,因此存储 I/O、NFS 等等待可能造成高负载、低 CPU 使用率的组合。 • 1、5、15 分钟负载是采样后的指数衰减平均值,必须结合 CPU 核数、运行时模型、I/O 与延迟指标共同判断。 推荐理由: 这是一篇能纠正常见运维直觉的底层文章。它不只解释“负载高”意味着什么,更追溯不同 Unix 系统在多核、线程和等待状态上的历史选择。对于需要排查性能问题、解读监控告警,或运行 Go 等高并发服务的工程师而言,它提醒我们:先理解指标由什么系统机制产生,再依据指标做决策。 --- 「Andrej Karpathy的RSS订阅清单」为您精选全球最前沿的AI技术博客文章,深度剖析技术背后的核心洞察。 由 voieech.com 提供技术支持。

Showing 1–20 of 93 episodes